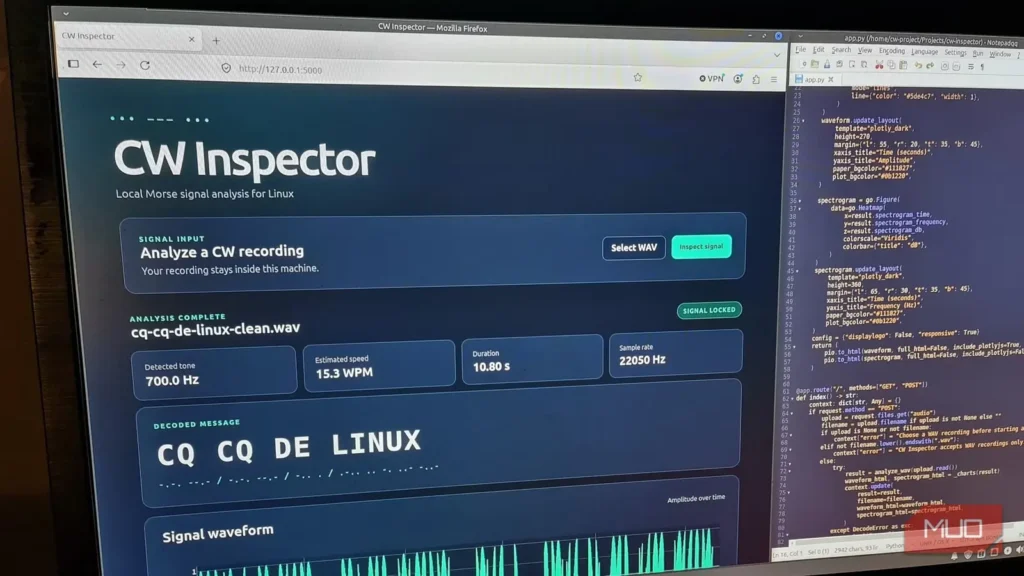
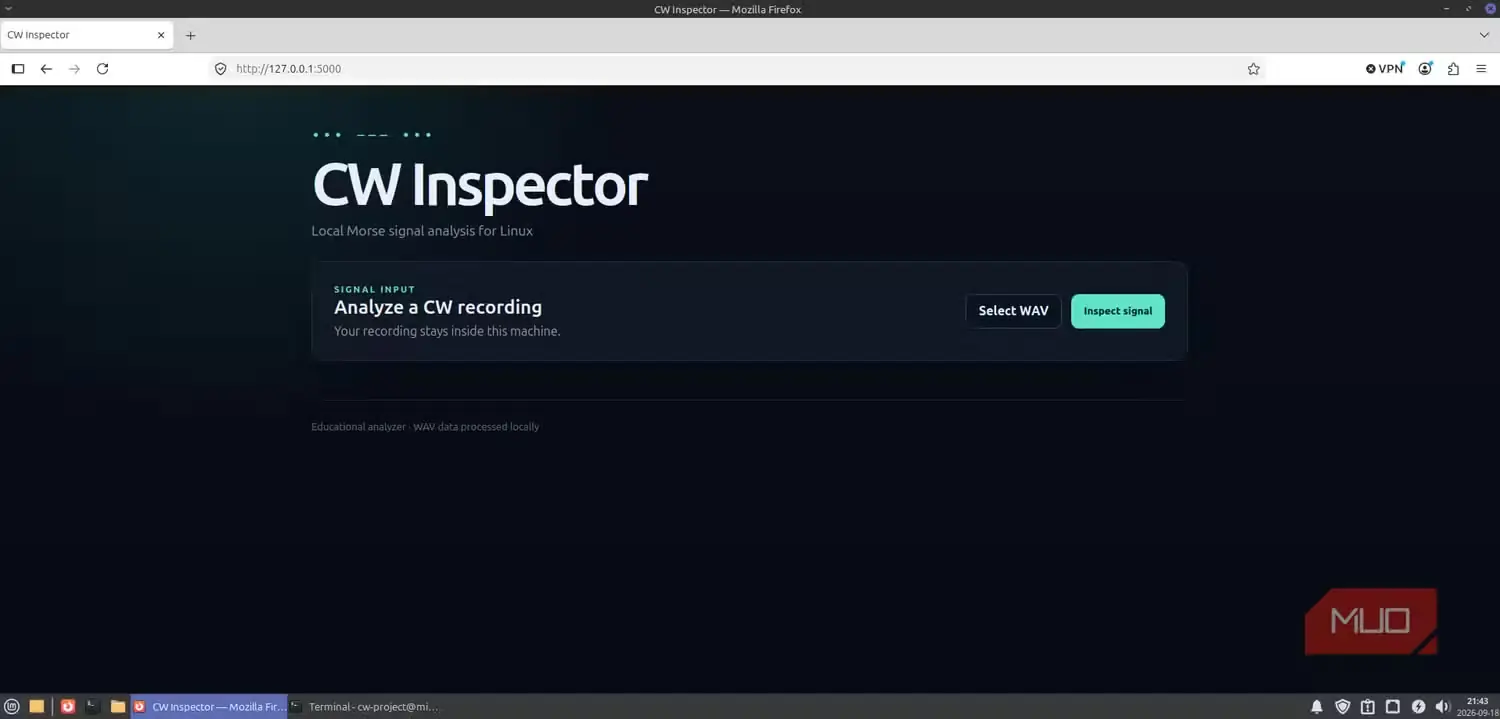
کاملاً درک میکنم که چرا وایبکدینگ تا این اندازه محبوب شده است. اینکه در جریان یک گفتوگو ببینید ایدههایتان به برنامهای کاربردی تبدیل میشوند، کموبیش جادویی به نظر میرسد. من هم با اشتیاق از همین روش برای ساخت CW Inspector بهره گرفتم؛ برنامهای محلی برای لینوکس که فایلهای WAV حاوی پیام مورس را از WebSDRهای آنلاین تحلیل و رمزگشایی میکند.
برنامه در آغاز درخشان عمل میکرد؛ اما بخش ناخوشایند ماجرا بعدتر آشکار شد، زمانی که کد مرتب و خوشساختِ تولیدشده همچنان به کسی نیاز داشت که آن را بفهمد و درستیاش را بررسی کند.
دقیقاً به همین دلیل است که دستورالعمل هسته لینوکس درباره محتوای تولیدشده با ابزارها برای وایبکدرها سودمند است. این دستورالعمل کد تولیدشده با هوش مصنوعی را یکسره رد نمیکند؛ بلکه میپذیرد که با افزایش نمایی چنین کدهایی، نگهداری از آنها میتواند دشوار شود.
من پنج قاعده شفافیت آن را وام گرفتم و برای آزمودن برنامه تولیدشده با هوش مصنوعی، آن را از صافی این قواعد گذراندم. خیلی زود روشن شد برنامهای که تصور میکردم بینقص کار میکند، با اطمینان کامل صدا را اشتباه رمزگشایی میکرد، بیآنکه حتی یک خطا گزارش دهد.
۱. ابزار هوش مصنوعی را نام ببرید
گفتن «ساختهشده با کمک هوش مصنوعی» سودمندتر از تظاهر به نوشتن همه کدها از صفر است
نخستین قاعدهای که وام گرفتم، احتمالاً سادهترینشان بود: ثبت کنید کدام ابزار بخش عمده پروژه، یا دستکم قسمتهای مهم آن را ساخته است. هسته لینوکس از مشارکتکنندگان انتظار ندارد نام تکتک ابزارهای اصلاح املا و دستور زبان، تکمیل خودکار، قالببندی کد یا تغییر نام متغیرها را ذکر کنند. این دستورالعمل تنها زمانی کاربرد دارد که ابزاری چیزی اساسی تولید کرده باشد؛ از جمله تابعها، پروندههای کد منبع، اصلاحیهها، ترجمهها یا گزارش تغییرات.
در مجموع، هرگاه مرز میان این موارد روشن نباشد، شفافیت انتخاب بهتر است.
برای CW Inspector، بخشهای مهم فرایند ساخت را اینگونه ثبت کردم:
- OpenAI Codex نخستین پیادهسازی را بر پایه مشخصات مکتوب من تولید کرد.
- Linux Mint ۲۲.۳ و Python ۳.۱۲.۳ محیط آزمایش را در اختیارم گذاشتند.
- Flask رابط کاربری را مدیریت کرد و NumPy و SciPy پردازش صدا را بر عهده داشتند.
- Plotly نمودارها را ترسیم کرد و Pytest، Mypy و Bandit نیز برای آزمون و بررسی کد به کار رفتند.
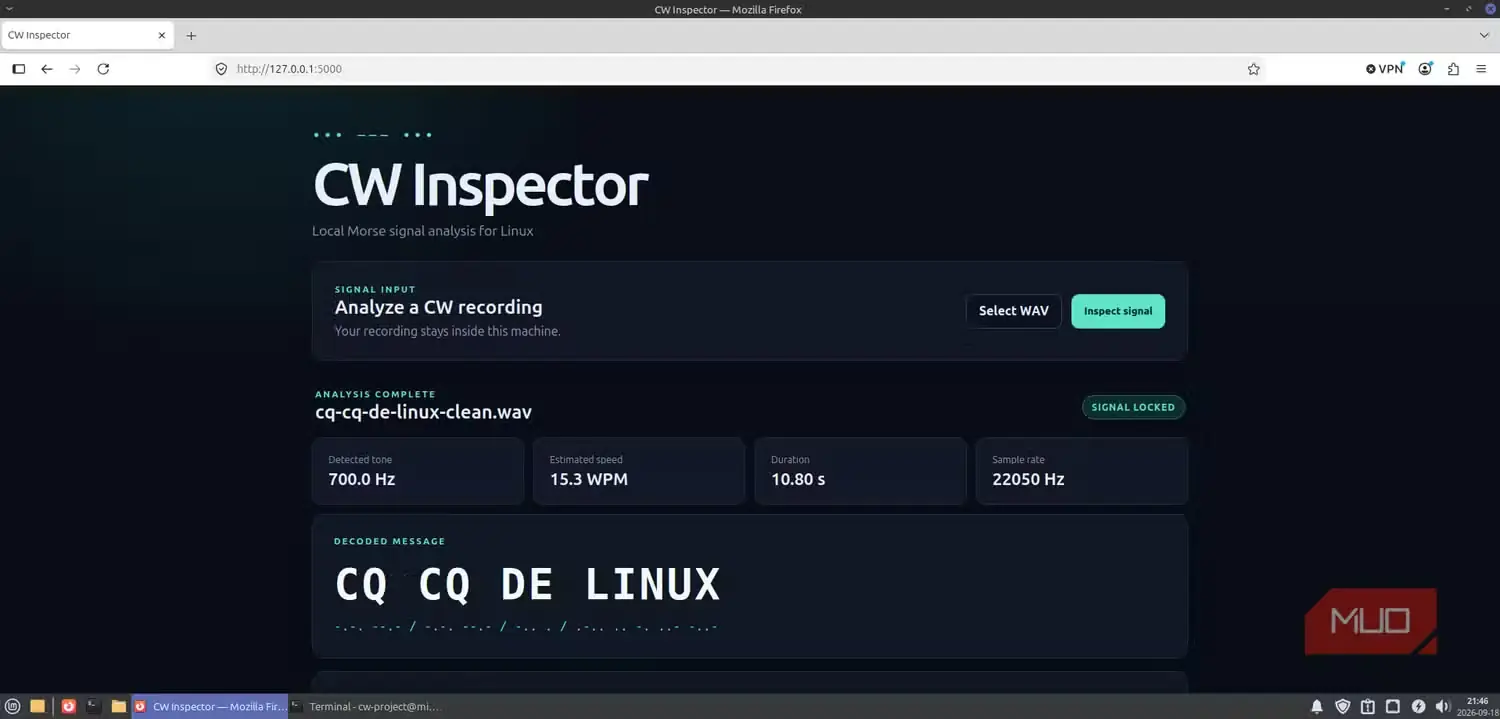
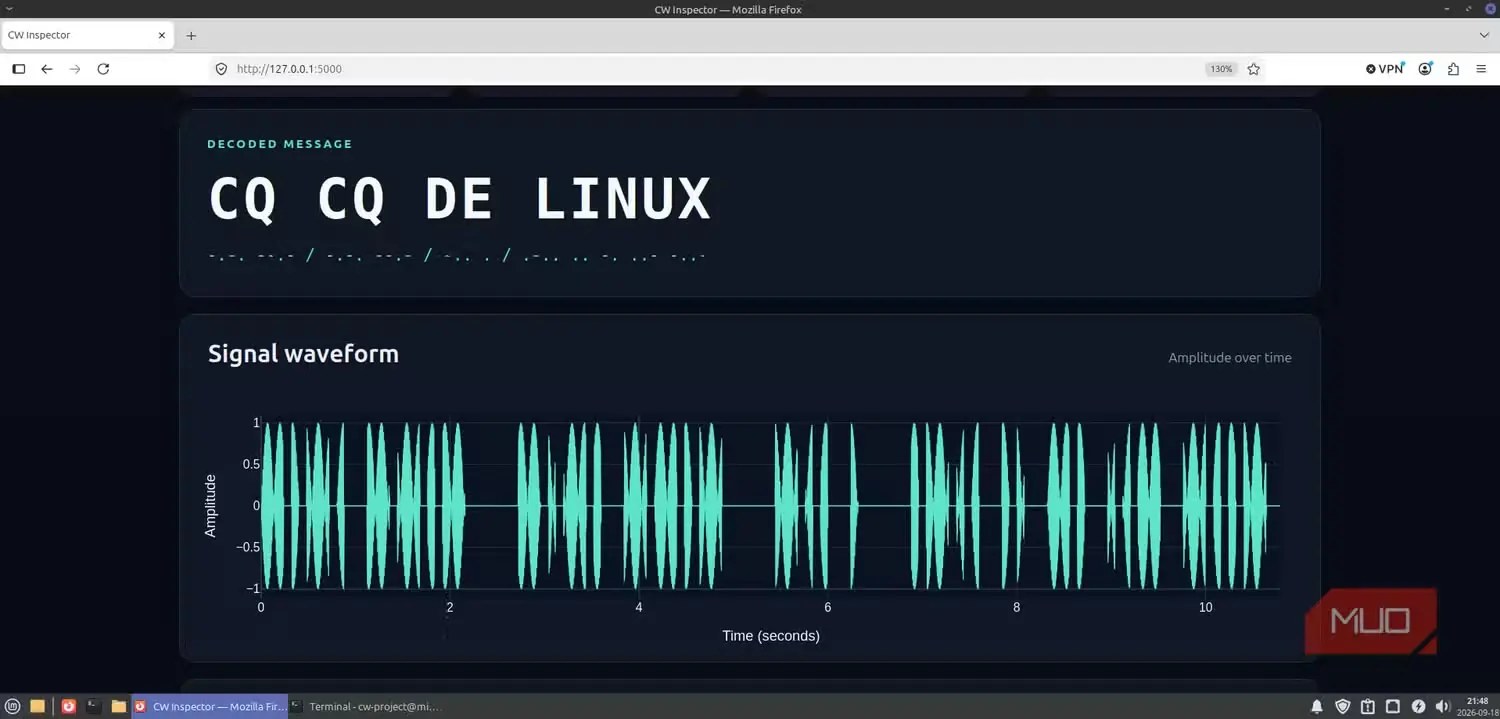
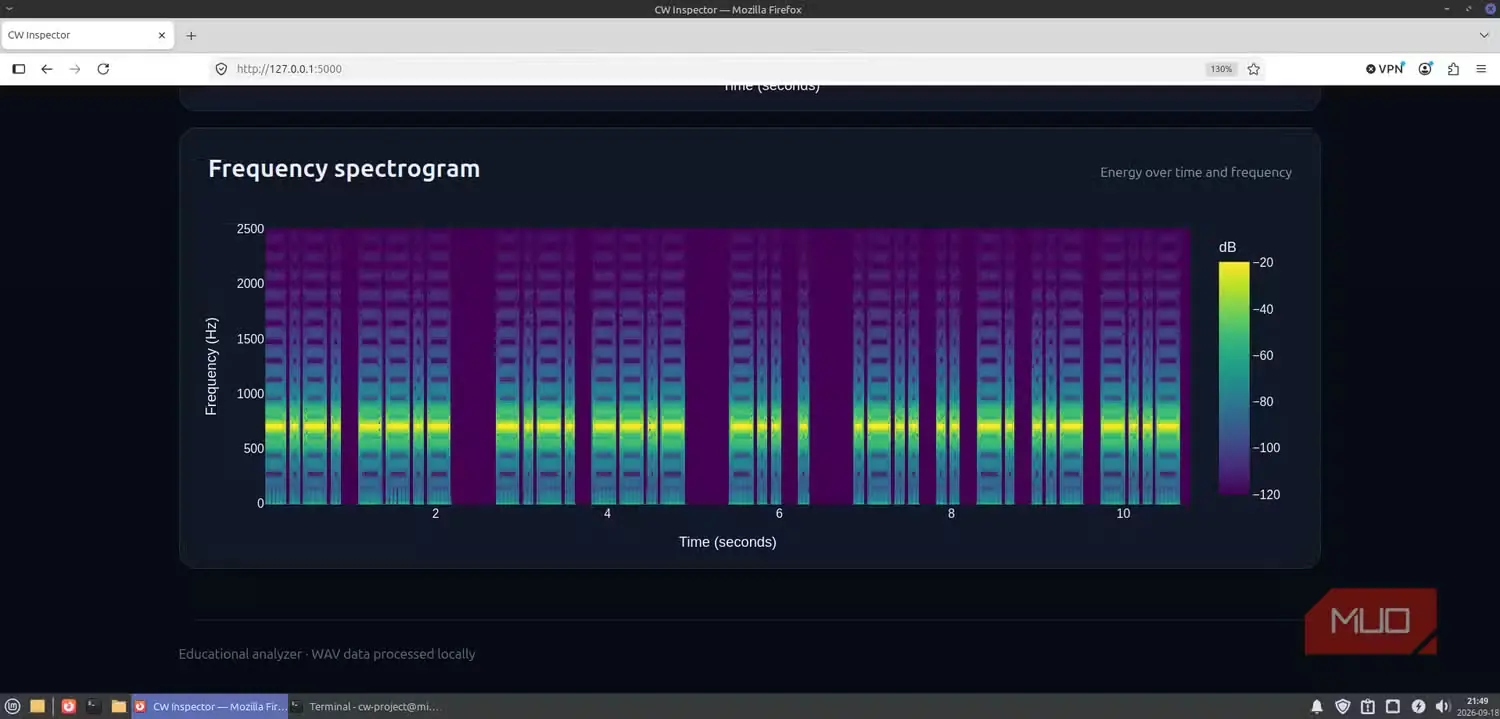
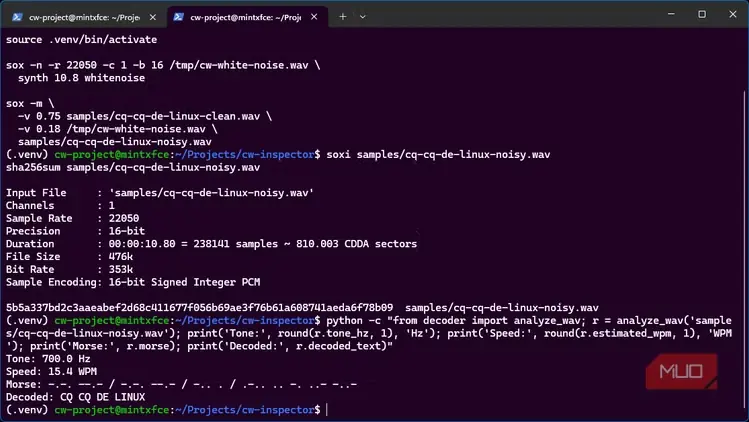
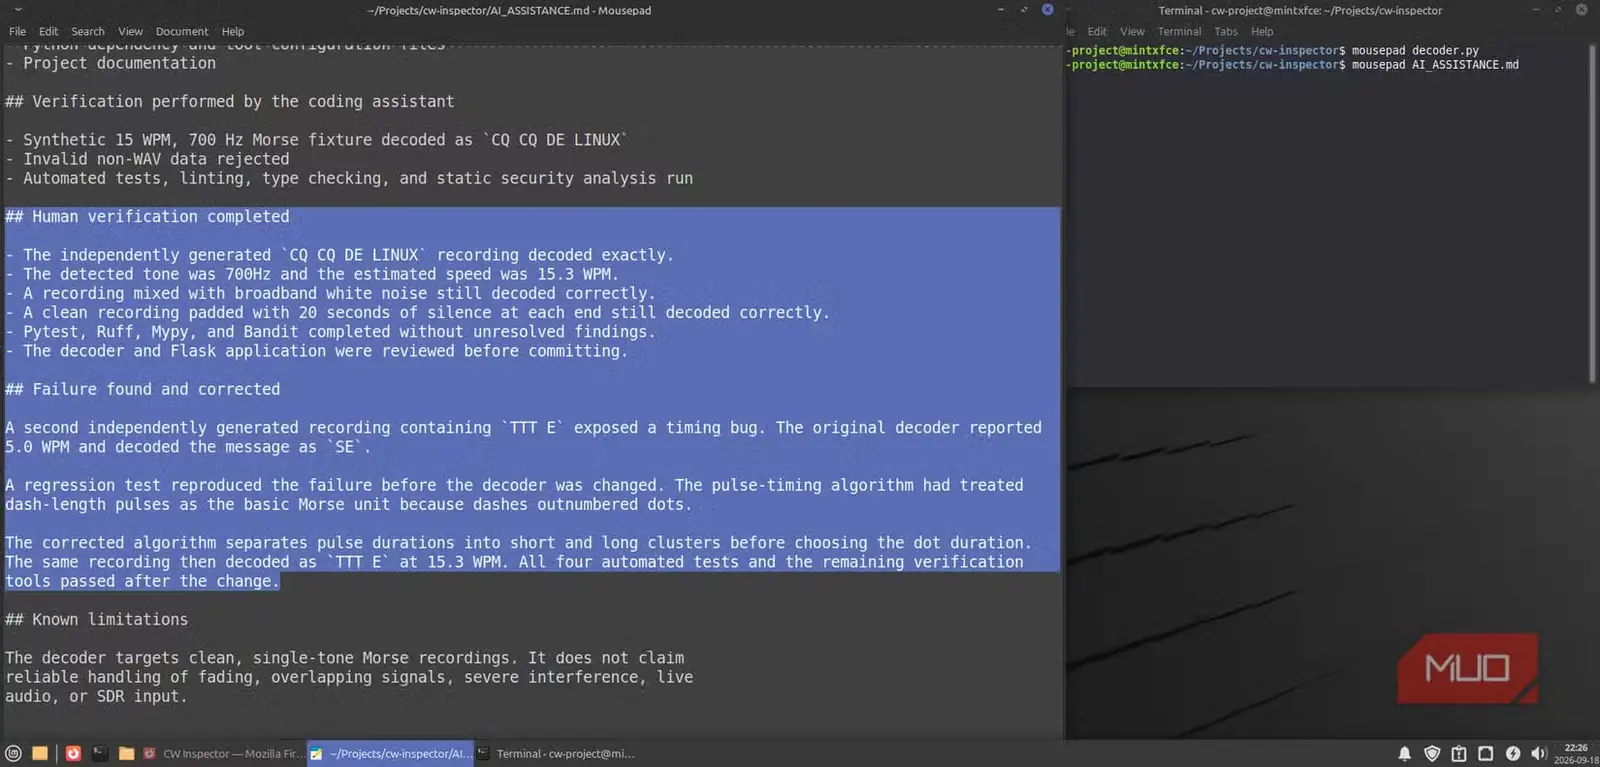
پیش از آنکه در تاریخچه توسعه کدی که خودم ننوشته بودم غرق شوم، برنامه نهایی را امتحان کردم. برنامه صدای ۷۰۰ هرتزی را در فایل WAV مستقلی که خودم ساخته بودم تشخیص داد، سرعت ۱۵٫۳ واژه در دقیقه را بهدرستی برآورد کرد و پیام CQ CQ DE LINUX را رمزگشایی کرد. همچنین شکل موج و طیفنگاره فرکانسی جذابی، شبیه آنچه Shazam به کار میبرد، ساخت و بار دیگر فایل WAV حاوی نویز سفید پهنباند و شدید را بهدرستی رمزگشایی کرد.
تا اینجا، اوضاع برای برنامهای که با وایبکدینگ ساخته شده بود خوب به نظر میرسید.
ذکر اینکه برای نخستین پیادهسازی از «OpenAI Codex» استفاده کرده بودم، چیزی از ارزش این موفقیتها کم نمیکرد؛ فقط نشان میداد کدام بخشها، در مقایسه با کدی که خودم نوشته بودم، به موشکافی بیشتری نیاز دارند.
۲. ورودیهای منتهی به نتیجه را نگه دارید
کد تولیدشده تنها در چارچوب اطلاعات دریافتی هوش مصنوعی معنا پیدا میکند
قاعده دوم این بود که دستورها و نیازمندیهای منتهی به نتیجه تولیدشده را نگه داریم. دستورالعمل هسته لینوکس از مشارکتکنندگان میخواهد مشخص کنند چه چیزهایی را در اختیار ابزار هوش مصنوعی گذاشتهاند؛ خواه منابع اولیه باشد، خواه اسکریپتهای تحلیلی یا هرگونه ورودی فنی دیگر.
پیش از آنکه Codex بخشی از برنامه CW Inspector را تولید کند، پرونده PRODECT_SPEC.md را نوشتم و در مخزن ثبت کردم. این سند موارد زیر را الزامی میدانست:
- یک رابط محلی مبتنی بر Flask که فایلهای WAV تککاناله با قالب PCM را بپذیرد.
- تحلیل شکل موج، طیفنگاره، زیروبمی صدا و سرعت.
- رونویسی مورس در کنار همه پیامهای رمزگشاییشده.
- جدا نگهداشتن منطق پردازش سیگنال از رابط وب.
- عدم استفاده از خدمات ابری یا فرمانهای پوستهای ساختهشده از نام پروندههای بارگذاریشده.
- آزمون خودکار و بیان صادقانه محدودیتها در برخورد با سیگنالهای ضعیف، محوشونده یا همپوشان.
برای آنکه برنامه مرجع صوتی مناسبی در اختیار داشته باشد، نمونهای را با مترجم مورسِ Coddy ضبط کردم. این نمونه، نقطهها و خطهای صوتی متناسب با پیام CQ CQ CQ DE LINUX در کد مورس را در قالب فایلی ۱۰٫۸ ثانیهای، تککاناله و با کدگذاری PCM شانزدهبیتی و نرخ نمونهبرداری ۲۲٬۰۵۰ هرتز در بر داشت. سیگنال نیز روی نوایی با بسامد ۷۰۰ هرتز و سرعتی در حدود ۱۵ واژه در دقیقه تنظیم شده بود.
Codex فرادادههای فایل ضبطشده و پیام مورد انتظار را دریافت کرد، اما خود فایل WAV در اختیارش قرار نگرفت. بهاینترتیب، یک آزمون پذیرش مستقل داشتم و مدل نمیتوانست صرفاً خود را برای همان نمونهای بهینه کند که قرار بود بعداً رمزگشاییاش کند. بدون حفظ چنین محدودیتهایی، بازآفرینی موفقیتها یا ریشهیابی شکستها چیزی جز حدسوگمان بیقاعده نخواهد بود.
۳. ردپای درخواستها را نگه دارید
فایل نهاییِ کد منبع نشان نمیدهد هوش مصنوعی مأمور بهینهسازی چه چیزی بوده است
قاعده سوم، حفظ ردپای درخواستهاست. راهنمای هسته پیشنهاد میکند هرگاه حتی یک یا دو درخواست کوتاه به تولید بخش مهمی از کد بهدست هوش مصنوعی انجامیده باشد، متن واقعی همان درخواستها نیز درج شود. برای نشستهای طولانیتر، این راهنما توصیه میکند مشارکتکنندگان بهجای آن خلاصه کنند چه خواستهاند و ابزار چگونه به آنها یاری رسانده است.
خلاصه نشست برنامهنویسیام را در AI_ASSISTANCE.md ثبت کردم. دستورهایی که به Codex داده شد، چنین بود:
- پیش از نوشتن هرگونه کد، مشخصات را بهطور کامل بخوان.
- فقط همان تحلیلگر محلی WAV را که درخواست شده است بساز.
- پردازش سیگنال را از Flask جدا نگه دار.
- از رابطهای برنامهنویسی خارجی و اجرای فرمانهای پوسته بر پایه نام فایل دوری کن.
- فراتر از دامنه تعریفشده پروژه، ادعای پشتیبانی نکن.
اگر فقط عبارتی مانند «برایم یک رمزگشای مورس بساز» را ذخیره کرده بودم، جزئیاتی که معماری برنامه و مرزهای امنیتی آن را شکل داده بودند پنهان میماندند. خلاصه درخواستها معیار ملموسی در اختیارم گذاشت تا پیادهسازی نهایی را با آن بسنجم.
درست است که درخواستها مانند دستور پختی نیستند که با هوشهای مصنوعی گوناگون همواره به کدی یکسان بینجامد، اما ارزششان در روشنکردن مقصود اولیه است. برای نمونه، وقتی برنامه بعدها پیامی سرشار از خط تیره را نادرست خواند، ردپای درخواستها اشکال را برایم برطرف نکرد، اما رفتار مورد انتظار را بهروشنی نشان داد.
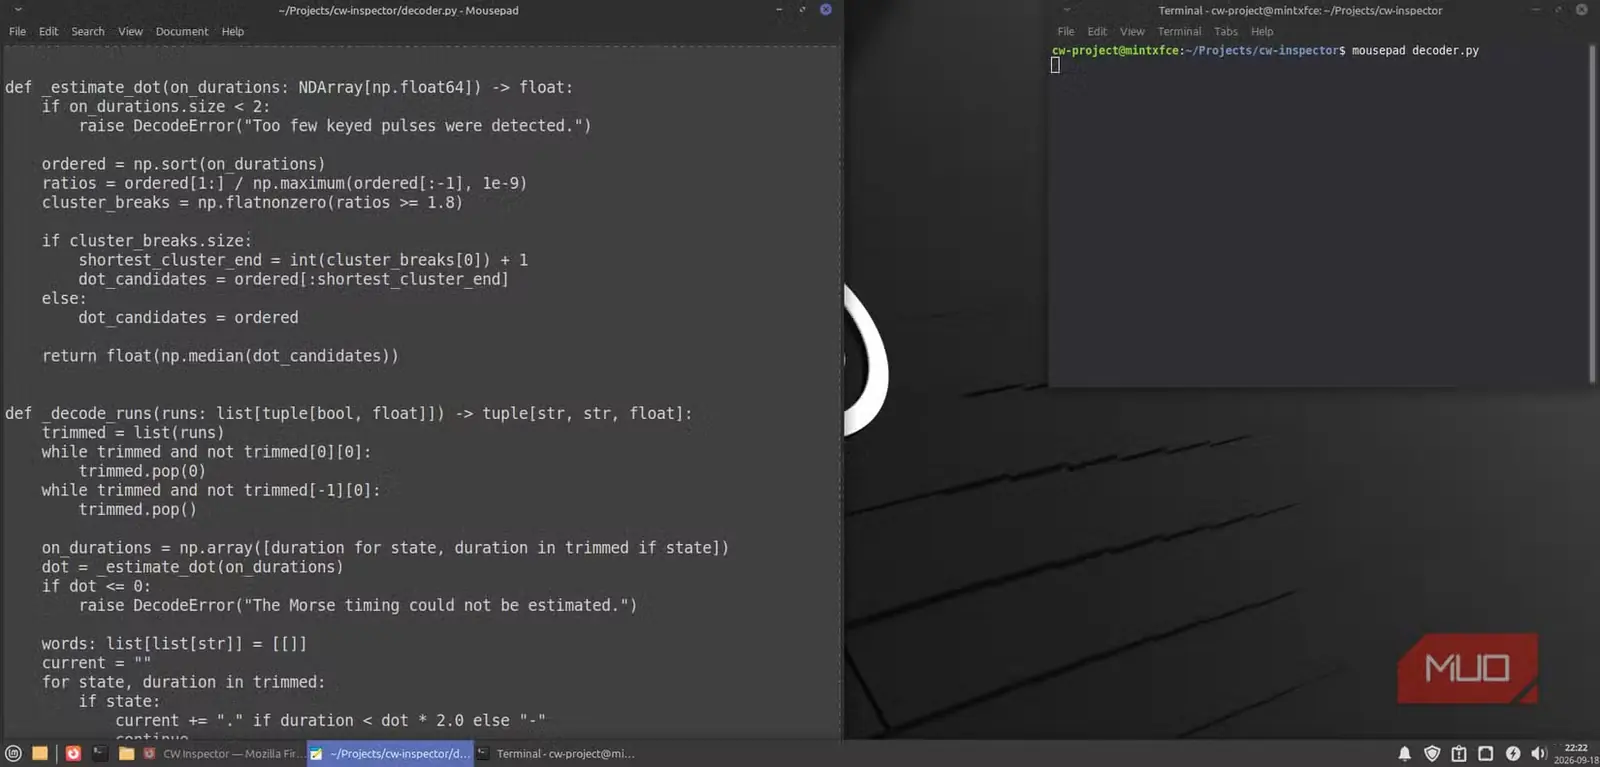
هنگام بررسی تابع اصلاحشده _estimate_dot، میتوانستم عملیات NumPy در آن را به هدفی مشخص پیوند دهم: جداسازی پالسهای کوتاهِ نقطه از پالسهای بلندترِ خط تیره. نوشتن مشخصات پیش از ارائه درخواستها، کار را بسیار کندتر کرد؛ اما در عوض، بازبینی نتایج ناآشنا را بسیار آسانتر ساخت.
۴. دقیقاً ثبت کنید هوش مصنوعی چه چیزهایی را تغییر داده است
انتساب زمانی سودمندتر است که به فایلها و تصمیمهای مشخص اشاره کند
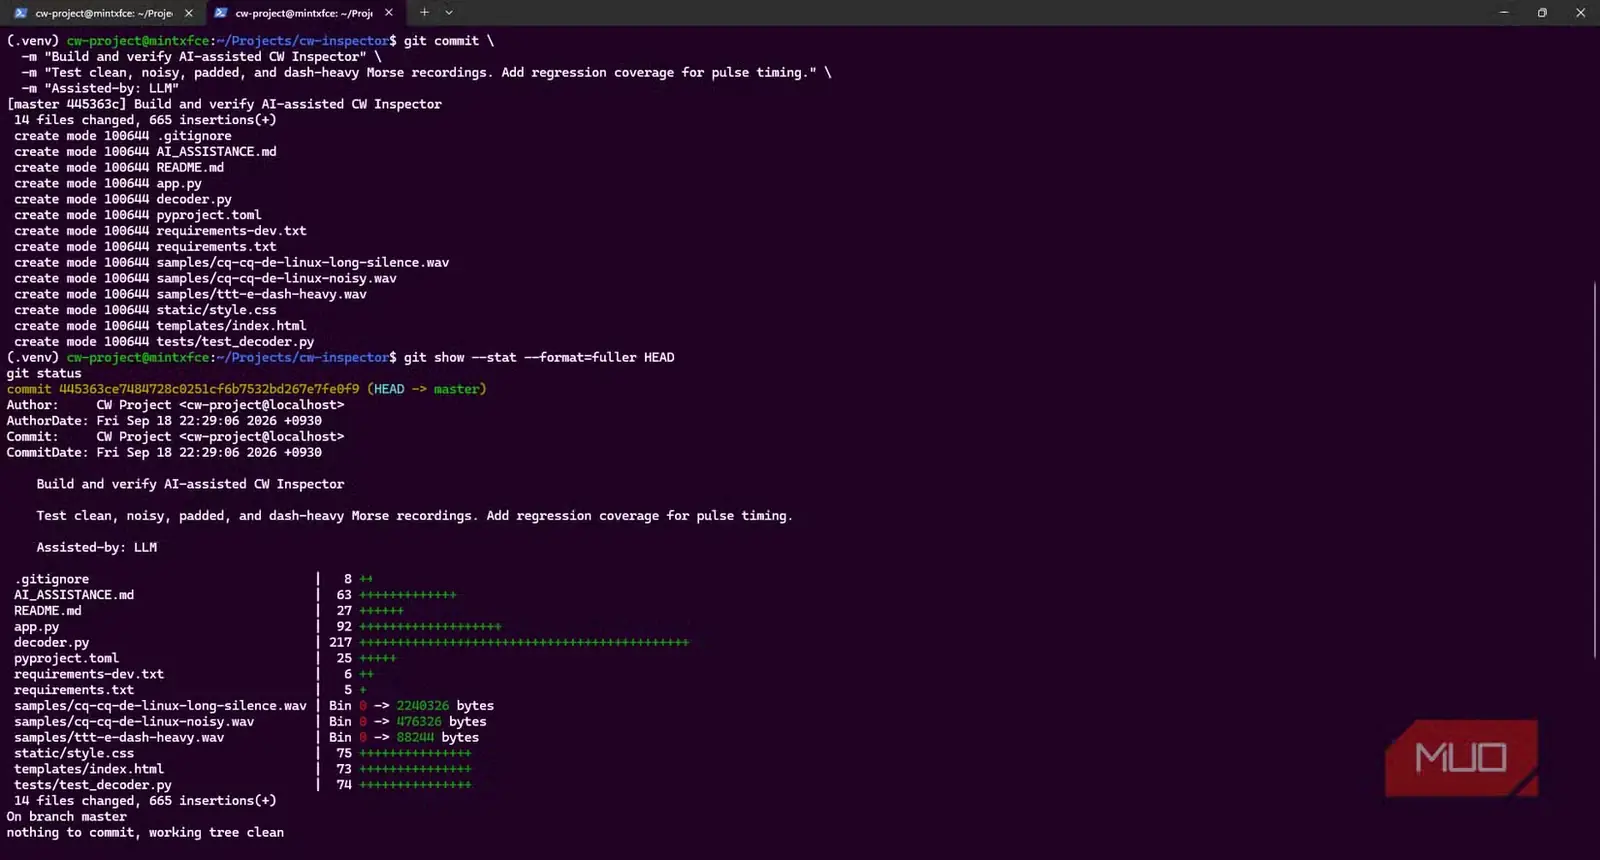
قاعده چهارم این بود که دقیقاً مشخص کنم هوش مصنوعی در کدام بخشهای پروژه نقش داشته و کدام بخشها حاصل کار خودم بوده است. گفتنِ صرفِ «هوش مصنوعی کمک کرد» برای بازبین روشن نمیکرد که این ابزار فقط چند خط کد پیشنهاد داده یا کل برنامه را ساخته است.
ازاینرو، در گزارش کمک دریافتی نام فایلهای مرتبط را آوردم:
- فایلهای app.py و decoder.py.
- قالب HTML و شیوهنامه.
- آزمونهای خودکار.
- پیکربندی وابستگیها و ابزارها.
- فایل README و مستندات پروژه.
این گزارش همچنین دادههای انسانی را از کار تولیدشده جدا میکرد. در این پروژه، مشخصات و نمونههای صوتی مستقلِ آزمون را من فراهم کردم و Codex نسخه اولیه برنامه و آزمونها را ساخت. سپس همهچیز را در ماشین مجازی کوچکِ آزمایشی اجرا کردم، فایلهای صوتی بیشتری ساختم، خروجی را بررسی کردم و در نهایت اصلاح انجامشده را پذیرفتم.
مدل حتی یک بار هم داوطلبانه از ضعف خود در تشخیص زمانبندی سخن نگفت؛ اما آزمون سرشار از خط تیره من این کاستی را آشکار کرد.
راهنمای ویژه هوش مصنوعی در هسته، حتی اگر هرگز قصد مشارکت در کد هسته را نداشته باشم، مرز سودمندی را ترسیم میکند: عامل هوش مصنوعی نمیتواند از طرف شخص دیگری مشارکتی را امضا کند. برای یک برنامه شخصی، درس عملی بسیار سادهتر است: نگذارید عامل برنامهنویسی ناخواسته به مرجع نهایی تصمیمگیری درباره آنچه ذخیره، منتشر یا همرسانی میشود تبدیل شود.
فایلهای تولیدشده را بازبینی کردم، ثبت نهایی Git را خودم انجام دادم و سپس یادداشت Assisted-by: LLM را افزودم. گواهی رسمی Signed-off-by هسته را کنار گذاشتم، زیرا برای پروژه کوچک و خصوصی من موضوعیتی نداشت.
حتی اگر «سیدبلیو اینسپکتور» هرگز به گیتهاب راه پیدا نکند، تاریخچهاش از این پس به منِ آینده میگوید چه کسی کد را تولید کرده، خودم چه چیزهایی را آزموده و تأیید کردهام و مرز مسئولیت کجا بوده است.
۵. وادار کردن کد تولیدشده به اثبات درستی خود
خطرناکترین نتیجه، فروپاشی برنامه نبود؛ پاسخی نادرست اما قاطع بود
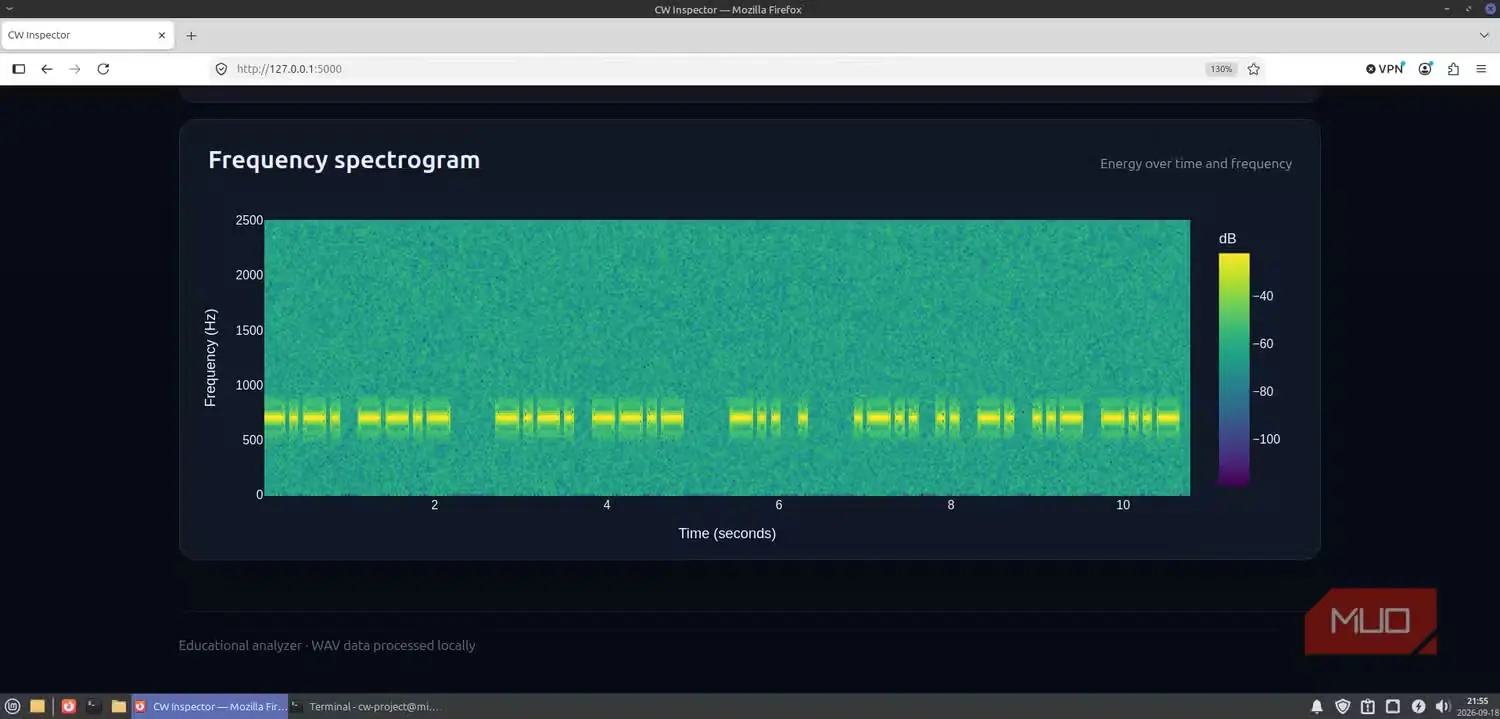
بهگمان من، قانون پنجم برای کدنویسان حسی از همه مهمتر است، زیرا وادارم میکند دقیقاً مستند کنم که نتیجهٔ تولیدشده چگونه آزمایش شده است. بهجای اعتماد به یک بار بارگذاری موفق، دشواری آزمونها را بهتدریج افزایش دادم:
- نمونهٔ مرجعِ پاک و بدون نویز، بهراحتی به
CQ CQ CQ DE LINUXرمزگشایی شد. - نویز سفیدِ پهنباند هم نتوانست عملکردش را مختل کند.
- افزودن بیست ثانیه سکوت پیش و پس از مخابره نیز مشکلی ایجاد نکرد.
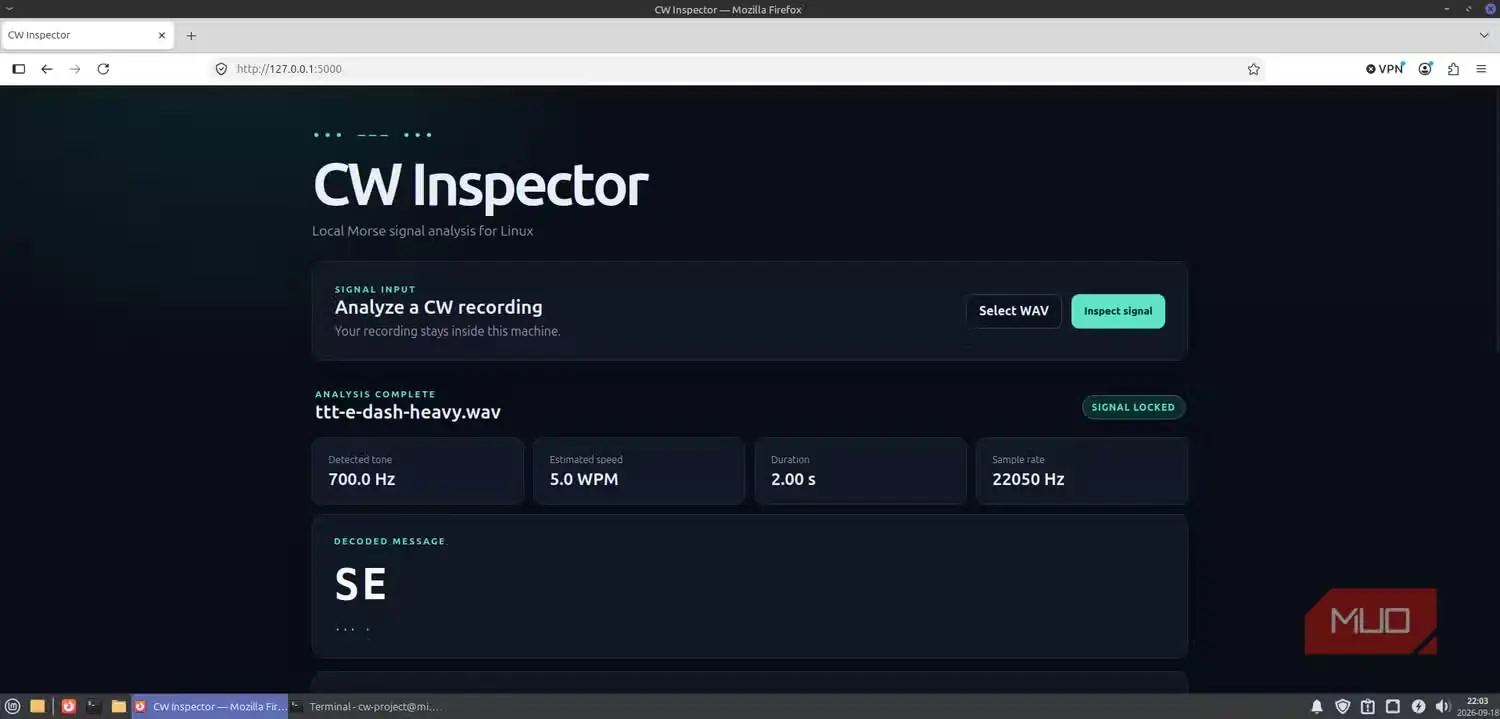
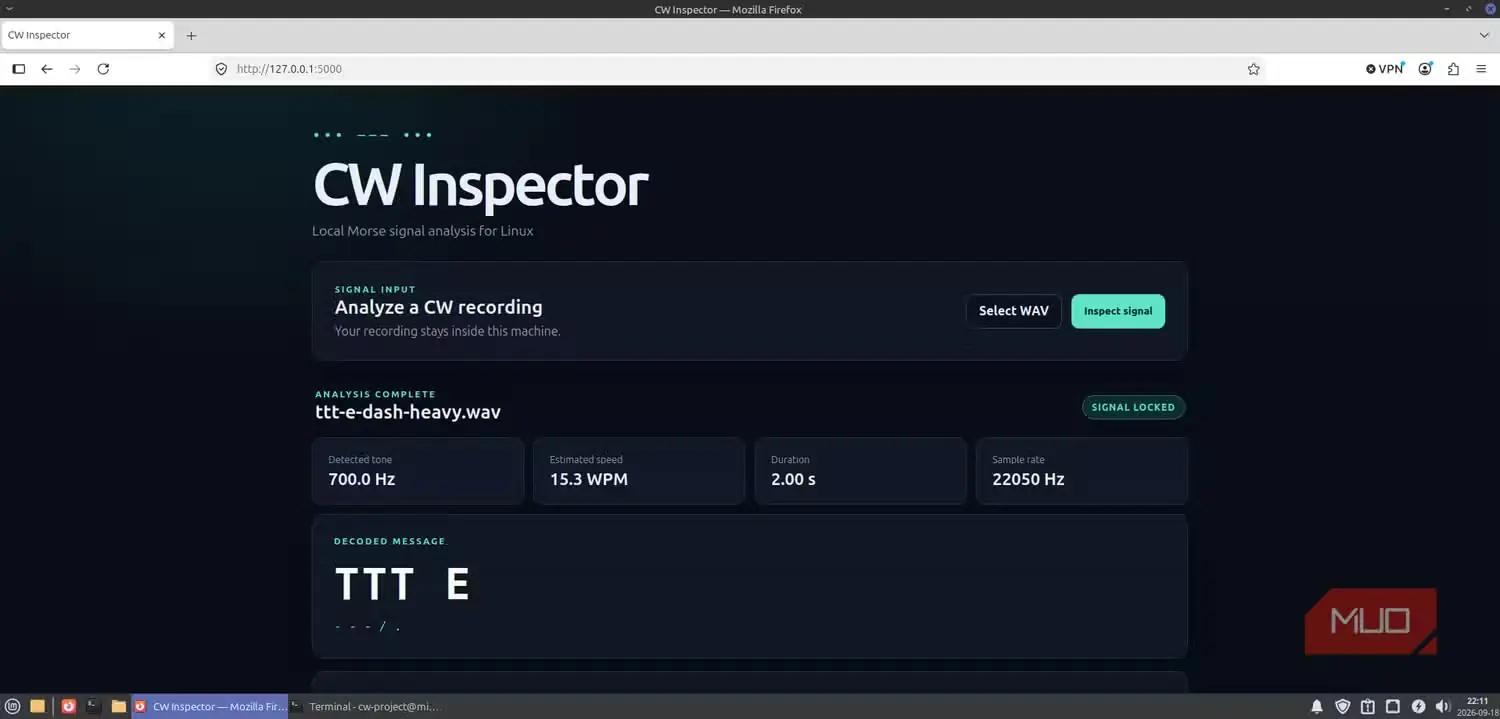
- سرانجام، یک فایل ضبطشدهٔ پُر از خط تیره که پیام
TTT Eرا در خود داشت، ایرادی بزرگ در زمانسنجی را آشکار کرد.
کد مورس درست - - - / . بود، اما «سیدبلیو اینسپکتور» آن را ... . نمایش داد، بهصورت SE رمزگشایی کرد و سرعت را بهجای حدود ۱۵ واژه در دقیقه، ۵.۰ واژه در دقیقه برآورد کرد. برنامه از کار نیفتاد و هیچ خطایی هم نشان نداد؛ در واقع، پاسخ نادرست خود را با اطمینان کامل ارائه کرد.
در کدنویسی حسی با هوش مصنوعی، اجرای بیخطای یک برنامه ثابت نمیکند که پاسخ آن درست است. خروجیِ باورپذیر اما نادرست، قاطع به نظر میرسد و با همان قاطعیت نیز ارائه میشود. چنین وضعی میتواند از یک شکست آشکار خطرناکتر باشد و نشان میدهد چرا قواعد هستهٔ لینوکس تا این اندازه سودمندند.
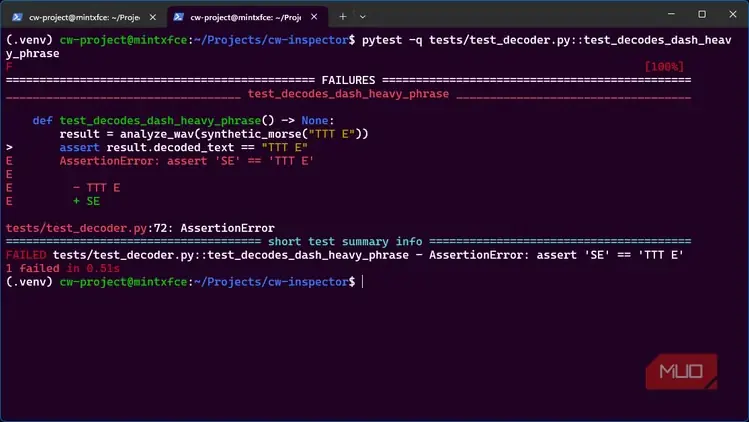
با پیروی از روال رفع اشکال هسته، مشکل را تأیید و آن را به یک آزمون تکرارپذیر پایتست تبدیل کردم. این آزمون بهطور رسمی ثابت کرد که رمزگشا بهجای TTT E، مقدار SE را برمیگرداند. تازه پس از آن بود که واقعاً کد را اصلاح کردم.
دانش من در زمینهٔ رادیوی آماتوری در اینجا نقشی اساسی داشت و اهمیت دخالت انسان در کدنویسی حسی را برجسته کرد. تجربه به من آموخته بود که اشتباه گرفتن T با E تا چه اندازه آسان است؛ بنابراین، آگاهانه پیامی سرشار از خط تیره ساختم که بررسی پاسخ درستش ساده بود.
الگوریتم اولیه، کوتاهترین ۵۵% از پالسهای کلیدزنیشده را نقطه در نظر میگرفت، اما حتی در آن گروه نیز خط تیرهها غالب بودند. ازاینرو، تابع بازنگریشده اکنون پیش از ثبت مدت نقطه، بهدنبال نسبت بزرگی میان خوشههای پالس کوتاه و بلند میگردد.
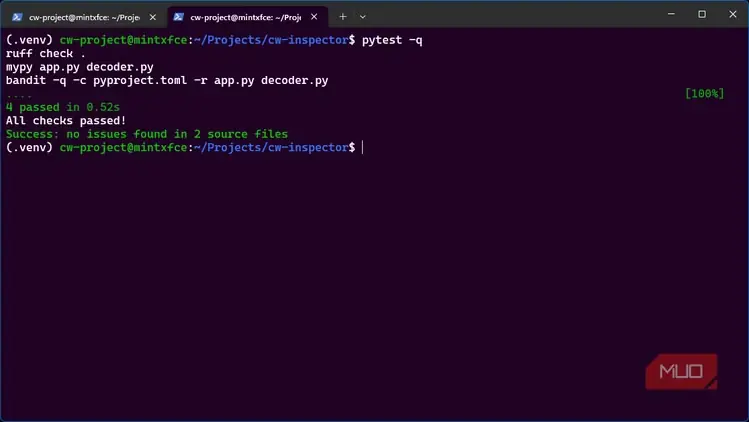
پس از اصلاح، همهٔ نمونههای صوتی TTT E بهدرستی رمزگشایی شدند، تمام آزمونهای پایتست با موفقیت گذشتند و مایپای هیچ خطای نوعی پیدا نکرد.
البته این فرایند بخشی از رضایت فوری و لذتبخشی را که کدنویسی حسی را چنین جذاب میکند، از میان میبرد. اجرای سختگیرانهٔ این قواعدِ همتراز با هسته برای تکتک برنامههای شخصی و یکبارمصرف، بیتردید زیادهروی است. بااینحال، بخشهای سودمندتر آن قطعاً ارزش نگهداشتن دارند: یک مشخصات روشن، یک گزارش همکاری، چند آزمون کوچک و ثبتهای صادقانه در گیت.
رهنمودهای هستهٔ لینوکس از ما نمیخواهند کدنویسی حسی را کنار بگذاریم؛ بلکه میخواهند هزینهٔ فهم کد را بر دوش نفر بعدی نیندازیم، حتی اگر آن فرد چیزی جز خودِ آیندهمان نباشد.
منبع: این مطلب ترجمه و بومیسازی مقالهای از MakeUseOf به قلم Gregory Gibson است. مشاهده مقاله اصلی