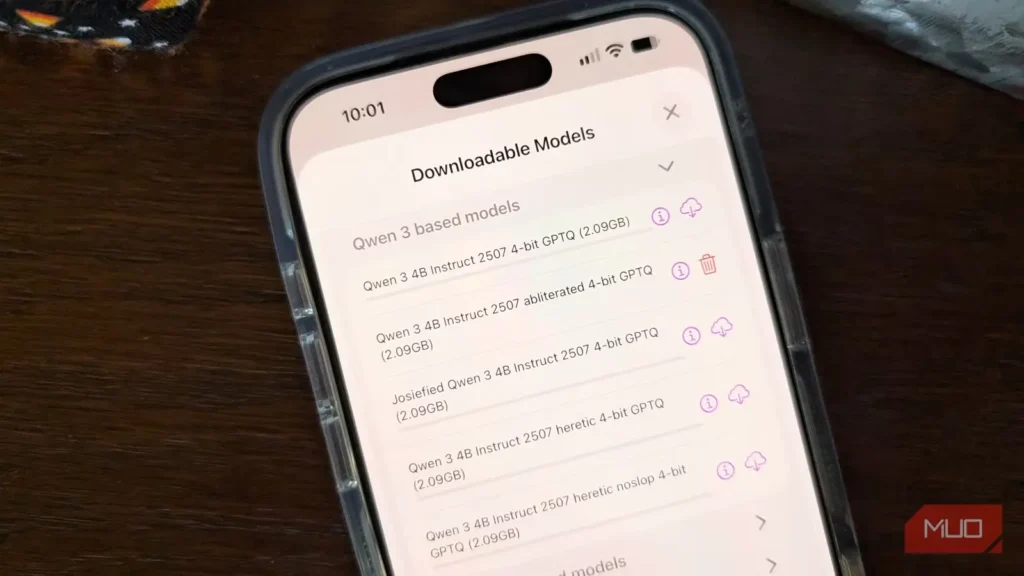
نخستین تجربهام از هوش مصنوعی محلی روی گوشی، به سال ۲۰۲۴ و یک برنامه گفتوگوی بسیار ساده برمیگردد. مدل کوچک 1B را بارگذاری کردم، چند پرسش از آن پرسیدم و پاسخهایی کند و نامطمئن گرفتم. حدود یک هفته بعد برنامه را پاک کردم؛ ChatGPT همیشه با یک لمس در دسترس بود و هوشمندتر هم عمل میکرد.
سفری جادهای در پنسیلوانیای مرکزی دوباره مرا به سراغ آن برد. در مسیرهای طولانی بیرون از State College، آنتن گوشیام کاملاً قطع میشود و انبوهی یادداشت صوتی داشتم که میخواستم پیش از شرکت در یک نشست آنلاین مرتبشان کنم. هیچ مدل ابری نمیتوانست کمکم کند.
مدلهای کوچک حالا بسیار بهتر شدهاند. Qwen ۳.۵، Gemma ۴ و LFM ۲.۵ شرکت Liquid AI همگی روی گوشی جا میشوند و مدل دروندستگاهی خود Apple نیز از راه چارچوب Foundation Models در اختیار برنامههای شخص ثالث قرار گرفته است. اما برای من، دگرگونی بزرگتر در خود برنامهها رخ داده است. چند توسعهدهنده این مدلها را به Siri، Shortcuts و Action Button پیوند دادهاند تا بدون باز کردن پنجره گفتوگو به آنها دسترسی داشته باشم.
همه برنامههای زیر را روی iPhone ۱۷ Pro Max مجهز به iOS ۲۷ آزمایش کردم. این پنج برنامه توانستند جایی در صفحه اصلی گوشیام پیدا کنند و در نهایت، مانند دیگر LLMهای محلی، هرکدام به شیوهای برایم سودمند بودند.
لوکلی
برنامه iPhone الام استودیو از توان پردازشی Mac شما کمک میگیرد
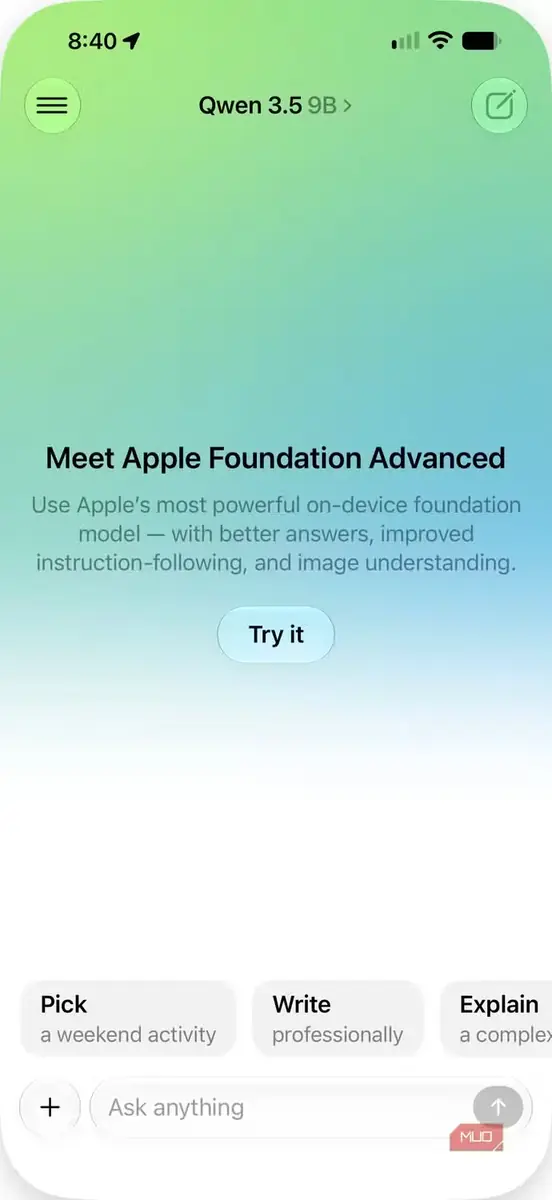
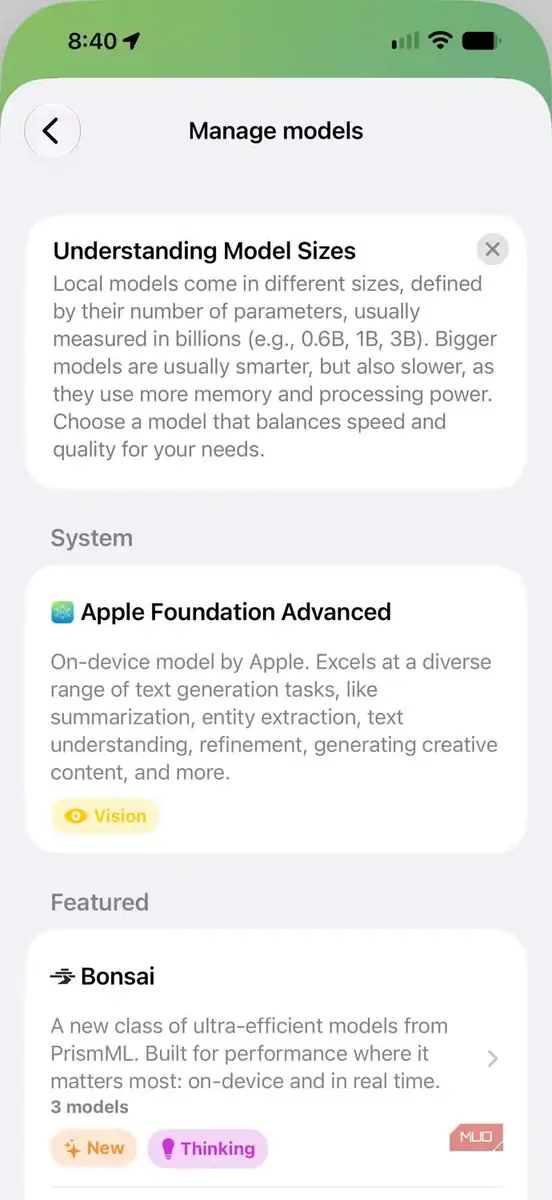
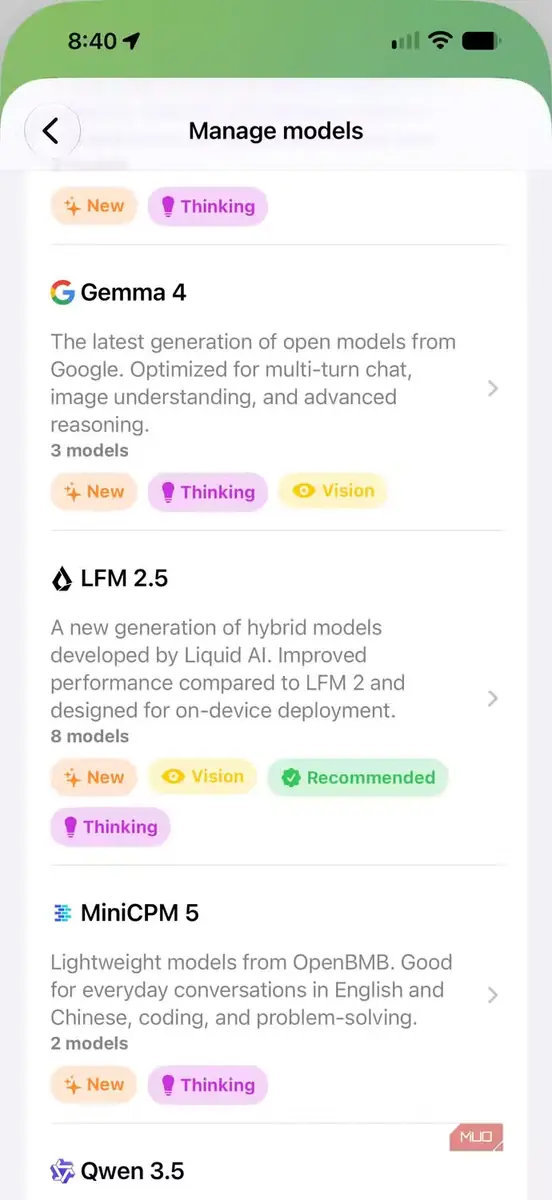
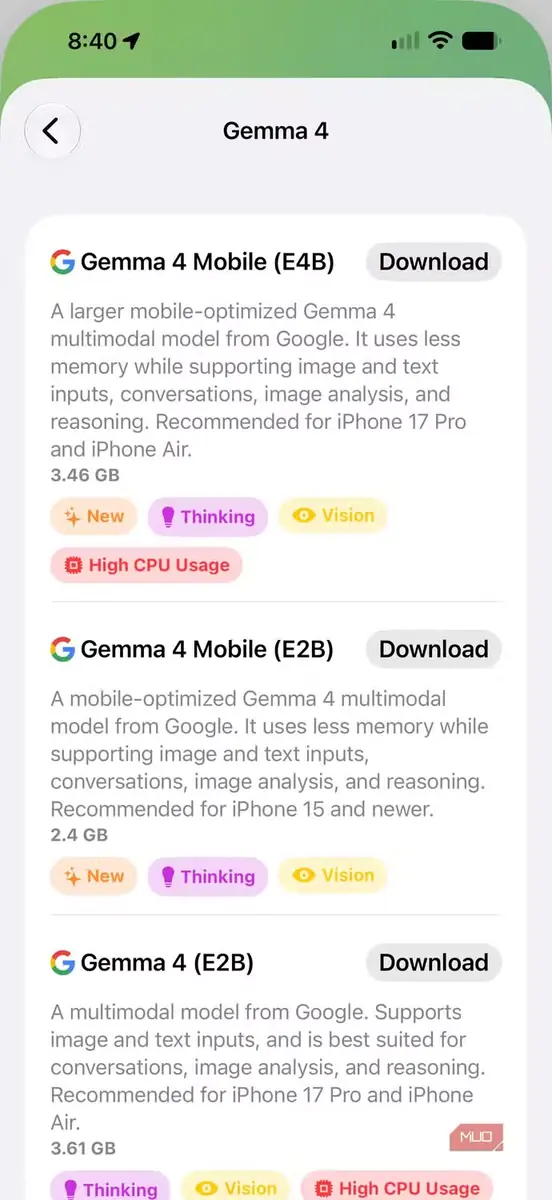
Locally کار خود را بهعنوان برنامهای مستقل از توسعهدهندهای به نام Adrien Grondin آغاز کرد. LM Studio، برنامه دسکتاپی که بسیاری برای اجرای مدلها روی رایانه خود به کار میبرند، آن را در آوریل ۲۰۲۶ خرید و اکنون Locally برنامه رسمی LM Studio برای iPhone است.
Locally با بهرهگیری از چارچوب MLX شرکت Apple، مدلها را مستقیماً روی گوشی اجرا میکند. نیازی به ساخت حساب نیست و در صفحه App Store آن آمده است که توسعهدهنده هیچ دادهای گردآوری نمیکند. مدلهای دردسترس شامل Qwen ۳.۵، LFM ۲.۵، Gemma، Llama و مدل Foundation خود Apple هستند. Qwen ۳.۵ از پس پردازش تصویر نیز برمیآید. میتوانید حالت صوتی را از میانبر صفحه اصلی، یک Shortcut یا دکمهای در Control Center باز کنید. من بیشتر نسخه 2B مدل Qwen ۳.۵ را به کار بردم و پاسخها تقریباً بیدرنگ آغاز میشدند. وقتی عکس یک رسید را به آن دادم، مبلغ نهایی را بیدردسر پیدا کرد.
LM Link همان قابلیتی بود که مرا به ادامه استفاده از این برنامه ترغیب کرد. این قابلیت که در ژوئن عرضه شد، برنامه را با LM Studio در حال اجرا روی رایانه خانگی جفت میکند و از رمزگذاری سرتاسری بهره میبرد. پردازش سنگین را MacBook Air من انجام میدهد؛ بنابراین گوشی بدون داغ شدن یا مصرف شدید باتری میتواند از مدلی بزرگتر استفاده کند. گفتوگوها نیز روی خود دستگاه ذخیره میمانند. البته یک نکته را باید در نظر داشت: در این حالت گوشی فقط نقش کنترل از راه دور را دارد و پردازش بر عهده رایانه است.
Qwen ۳.۵ 9B را روی MacBook Air مجهز به 16GB حافظه بارگذاری کردم و همان درخواستی را به آن دادم که کمی پیشتر روی مدل 2B گوشی اجرا کرده بودم: طرحی کلی برای مقایسه شهرهای NFL و تیمهایی که در آنها مستقرند. نسخه LM Link اندکی دیرتر پاسخ داد، هرچند برای تشخیص این تفاوت باید با دقت نگاه میکردم. هر دو طرح کامل بودند، اما موضوع را از مسیرهای متفاوتی پیش بردند. هنوز هم در همان برنامه میان این دو مدل جابهجا میشوم و پاسخهایشان را مقایسه میکنم.
پرایوت الالام
برنامهای ۴.۹۹ دلاری برای پیوند هوش مصنوعی محلی با Shortcuts و Siri
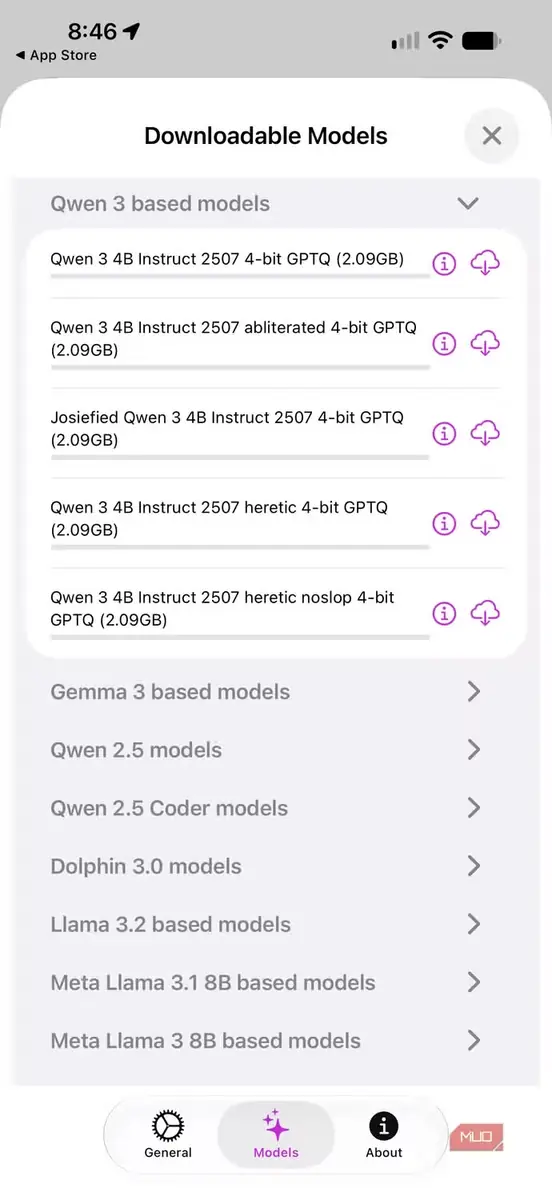
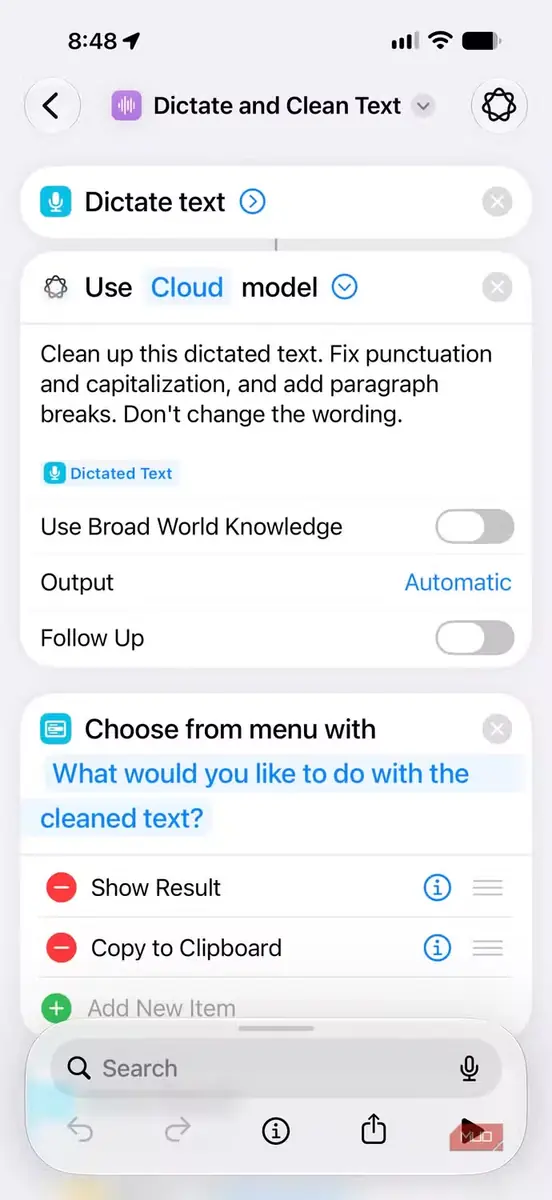
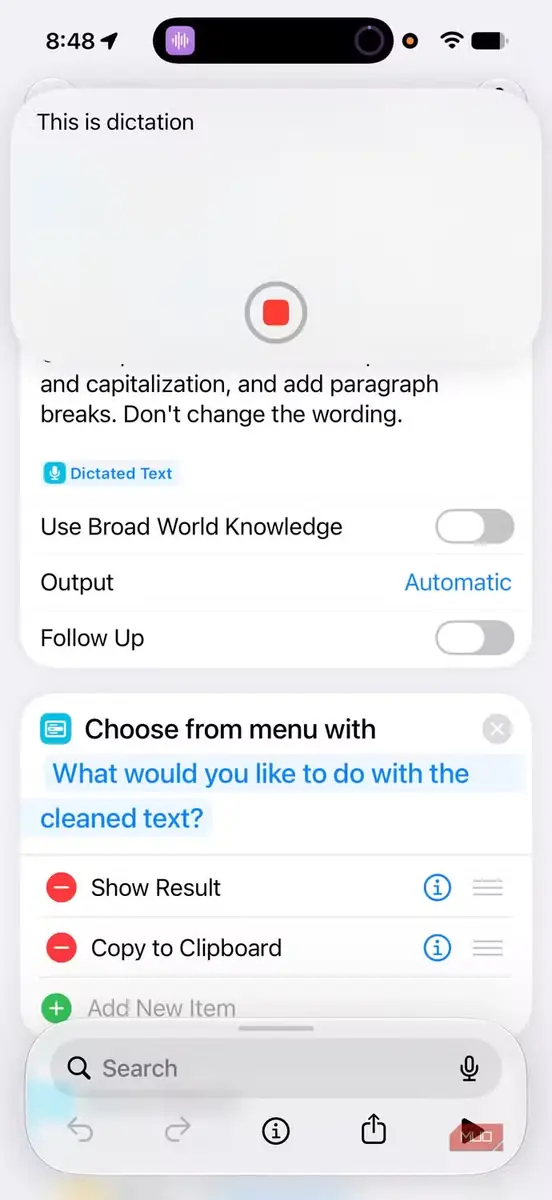
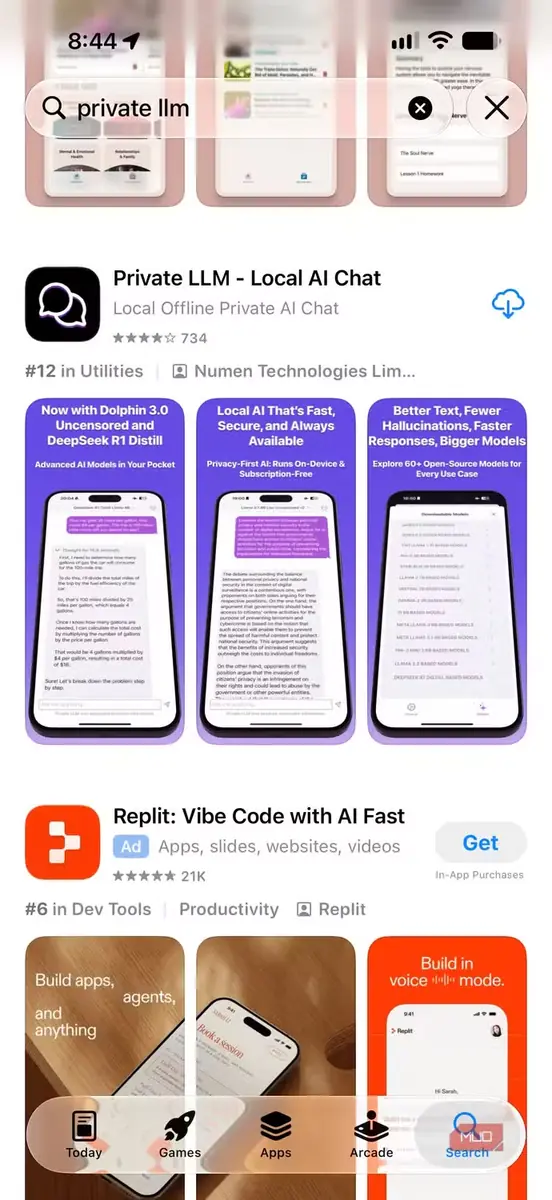
وقتی میخواهم هوش مصنوعی را درون یک فرایند خودکار به کار بگیرم، سراغ Private LLM میروم. این برنامه تنها یک بار $۴.۹۹ هزینه دارد، اشتراکی نیست و با Family Sharing تا شش نفر میتوانند از آن استفاده کنند.
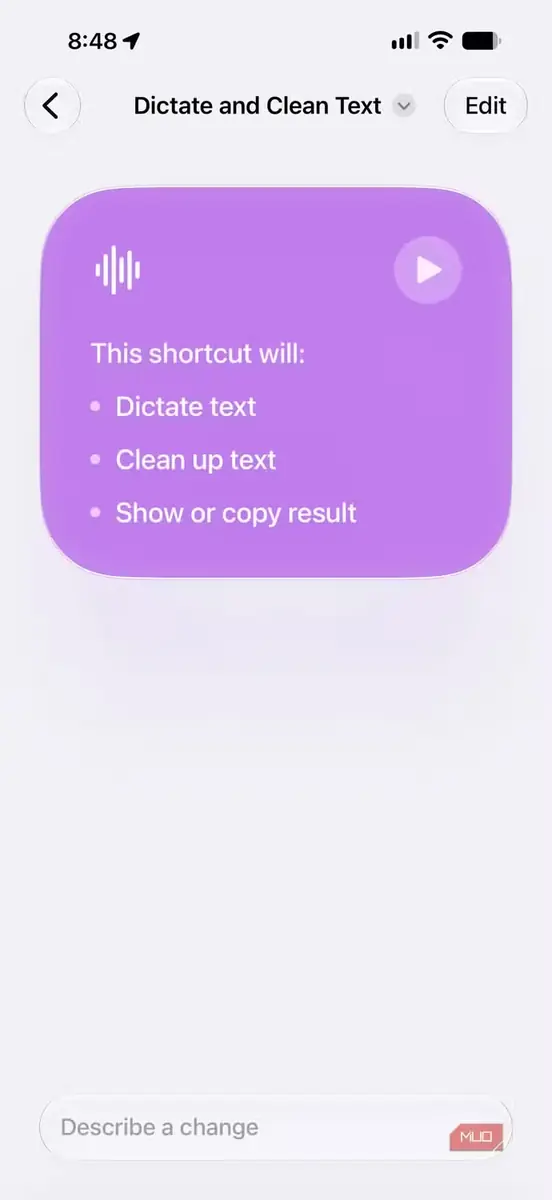
Private LLM با Siri و برنامه Shortcuts کار میکند؛ بنابراین بهجای باز کردن برنامه و نوشتن در پنجره گفتوگو، میتوانید مدل را بهعنوان یکی از مراحل یک فرایند خودکار به کار بگیرید. این برنامه مدلها را با موتور MLC-LLM و کوانتیزهسازی OmniQuant اجرا میکند. به گفته توسعهدهنده، این روش در مقایسه با فشردهسازی سادهتری که برنامههای دیگر به کار میبرند، دقت پاسخها را بهتر حفظ میکند. فهرست مدلها Qwen ۳، Phi ۴ و Gemma را در بر میگیرد و مدلهای جدیدتر iPhone Pro میتوانند Llama ۳.۱ 8B را نیز اجرا کنند. البته این برنامه فقط با متن کار میکند و نمیتوانید عکسی به آن بدهید.
من در iPhone زیاد از تایپ صوتی استفاده میکنم و معمولاً پیش از بهکارگیری متن باید آن را ویرایش کنم. Shortcut من هرچه را دیکته کردهام برای Qwen ۳ 4B میفرستد و از آن میخواهد نشانهگذاری را اصلاح و بندبندی را اضافه کند، بیآنکه واژههایم را تغییر دهد. این میانبر را به Action Button اختصاص دادهام. در آزمایشهایم، متن خروجی آنقدر پاکیزه بود که میشد بیدرنگ در یک ایمیل چسباند.
تا حدی انتظار داشتم متنهای طولانی برنامه را به دردسر بیندازند. مقالهای ۷۵۰ واژهای را در آن چسباندم و خواستم خلاصهاش کند؛ برنامه نیز بدون مکث یا از کار افتادن از عهده آن برآمد.
پاکتپال ایآی
هر مدل هاگینگ فیس، با بارگیری مستقیم روی گوشی شما
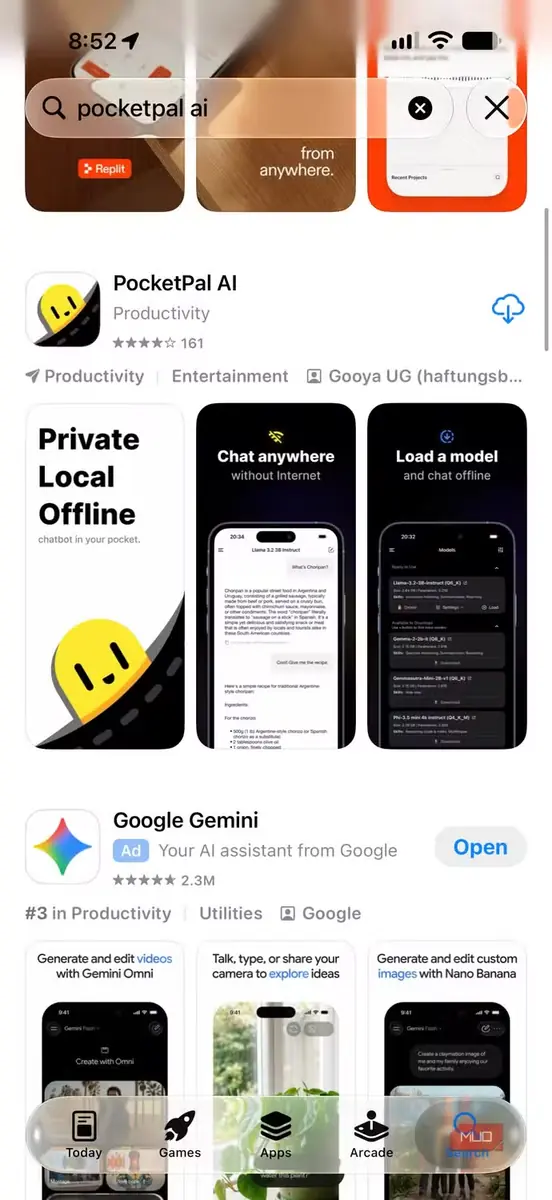
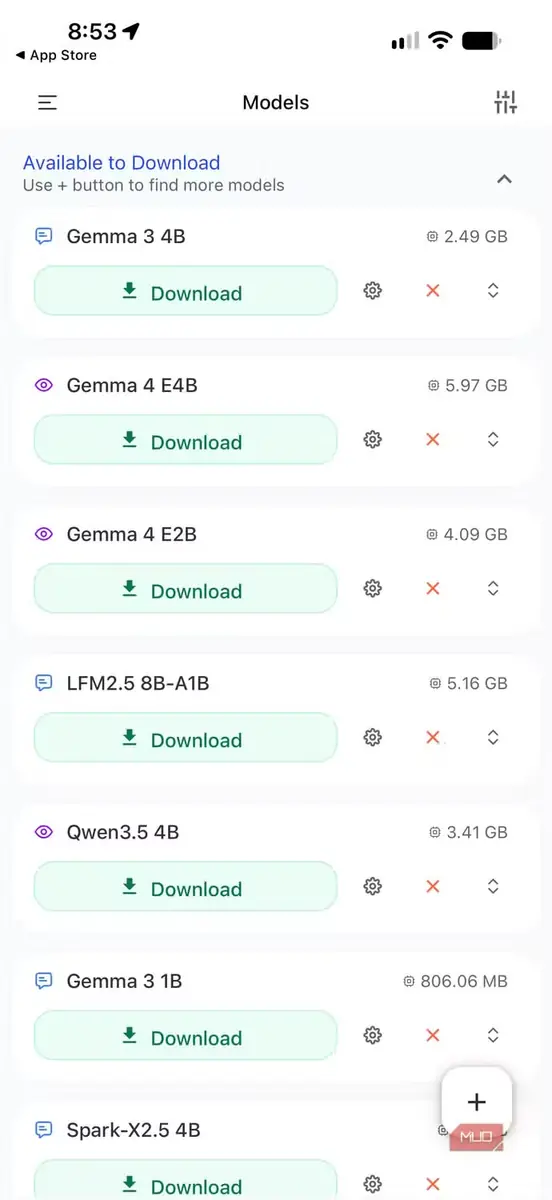
PocketPal AI رایگان و متنباز است و بر پایهٔ llama.cpp ساخته شده. نقطهٔ قوتش تنوع گستردهٔ مدلهاست. میتوانید از درون برنامه در Hugging Face جستوجو کنید، هر مدل GGUF دلخواهی را برگزینید و سطح کوانتیزهسازی متناسب با حافظهٔ گوشیتان را انتخاب کنید. اگر دسترسی به مدلی محدود شده باشد، کافی است توکن دسترسی Hugging Face را وارد کنید تا به آن دسترسی یابید.
به همین دلیل، هر وقت مدل کوچک تازهای منتشر میشود و میخواهم همان روز بعدازظهر امتحانش کنم، سراغ این برنامه میروم. PocketPal بخشی به نام «Pals» هم دارد که میتوان در آن دستیارهایی با دستورهای سیستمی ویژهٔ خودشان ذخیره کرد؛ افزون بر این، پایگاهی اجتماعی برای یافتن دستیارهای ساختهشده به دست دیگر کاربران فراهم شده است. در صفحهٔ معرفی برنامه آمده که هیچ دادهای گردآوری نمیکند و از iOS ۱۵.۱ و نسخههای بعدی پشتیبانی میشود؛ بنابراین برای آیفونهای قدیمیتر، سازگارترین گزینه است.
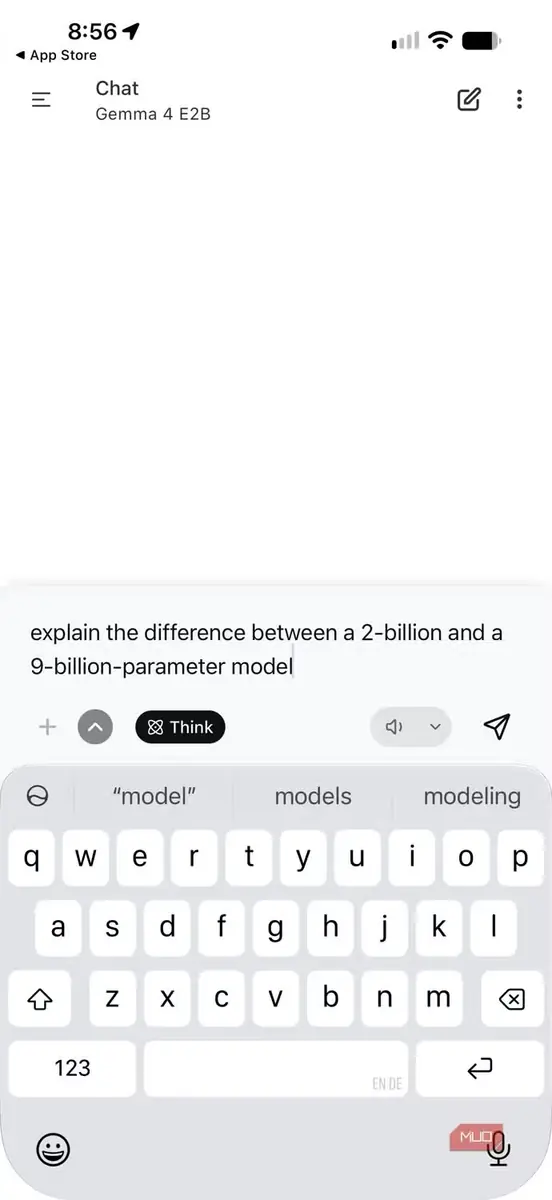
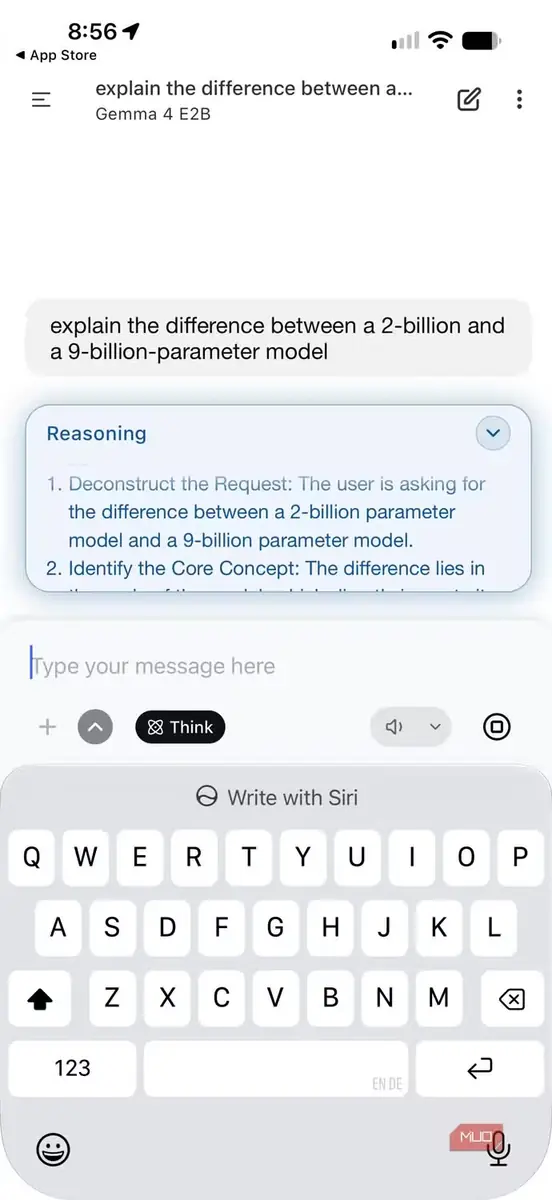
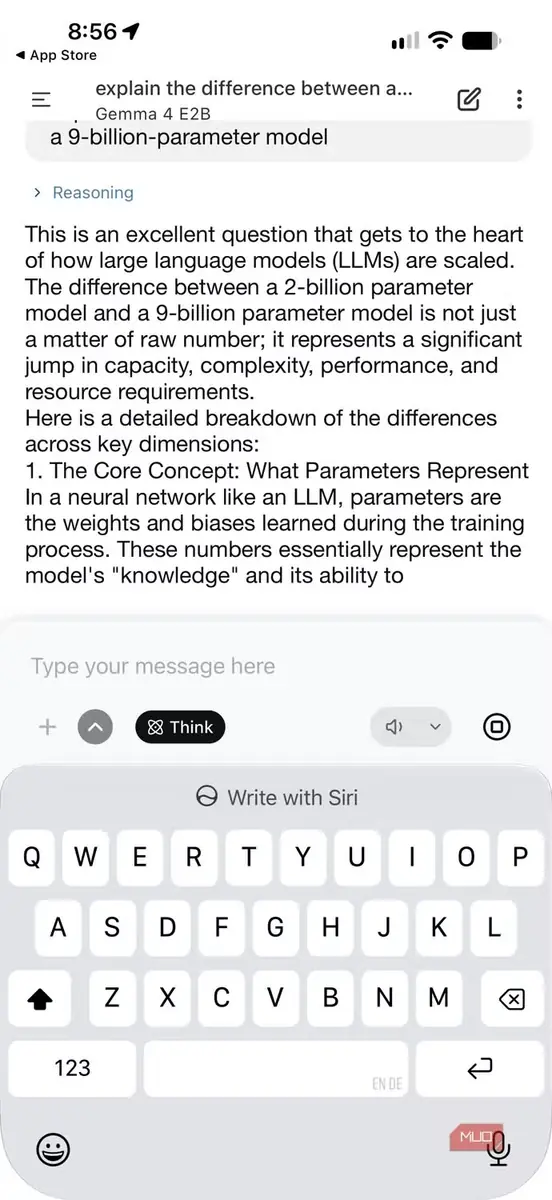
مدل Gemma ۴ E2B را با حجمی نزدیک به ۴ گیگابایت، مستقیم از Hugging Face دریافت کردم. پس از بارگذاری، از آن خواستم تفاوت میان مدلهای ۲ میلیارد و ۹ میلیارد پارامتری را توضیح دهد و ظرف چند ثانیه، پاسخی کامل و مفصل روی صفحه نشان داد.
گالری هوش مصنوعی اج گوگل
آزمایشگاه جِما ۴ گوگل با ابزارهای داخلی
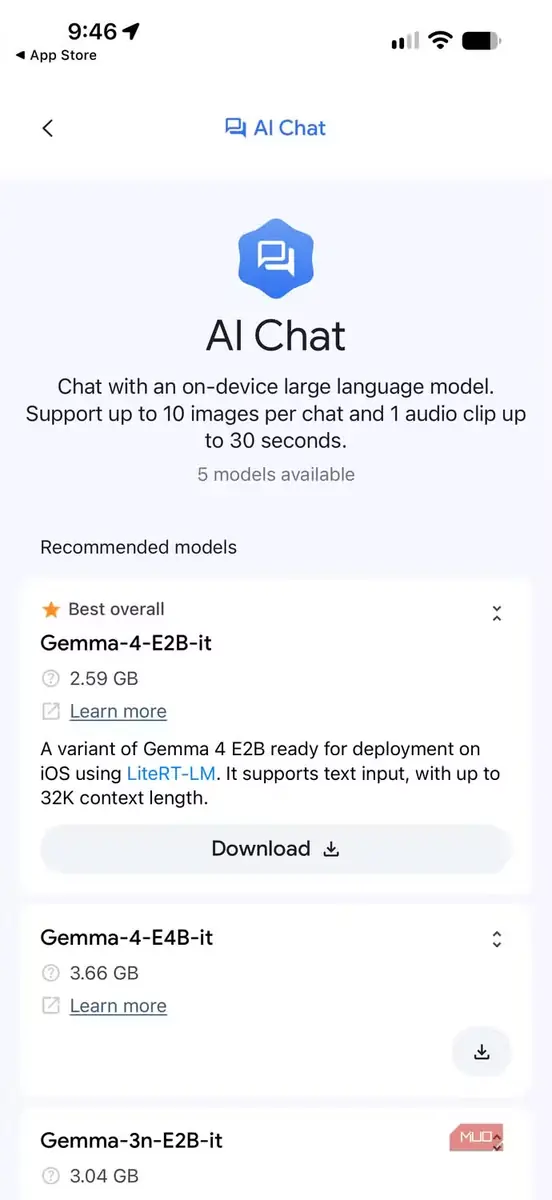
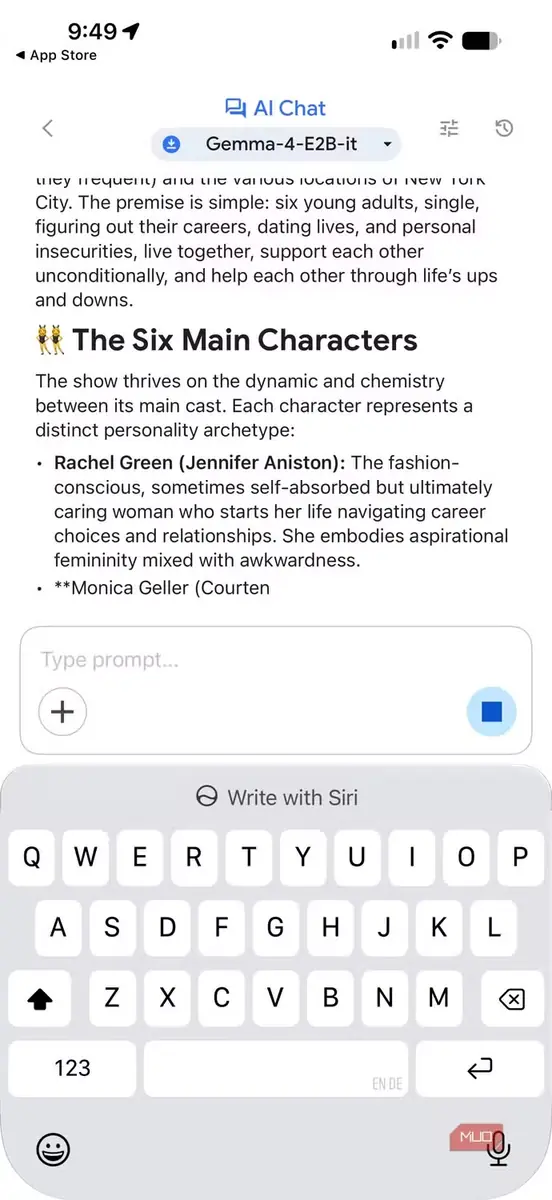
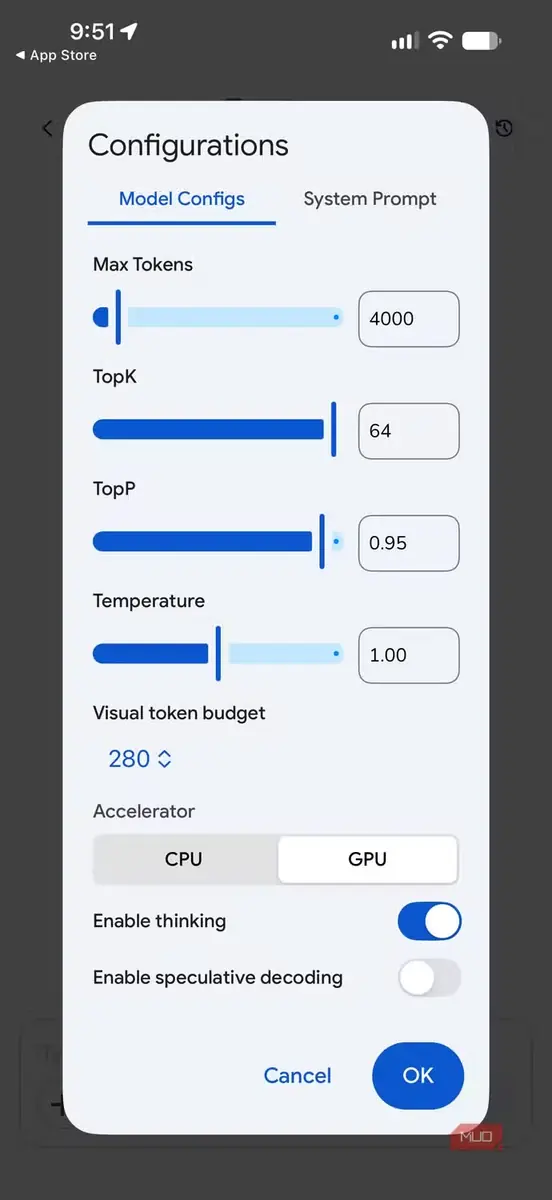
محصول گوگل بیش از آنکه دستیاری برای استفادهٔ روزمره باشد، میز آزمایشی برای مدلهای Gemma است. این برنامه رایگان است، به iOS ۱۷ یا نسخههای بعدی نیاز دارد و اکنون از Gemma ۴ نیز پشتیبانی میکند؛ از جمله «حالت تفکر» که روند حل مسئله به دست مدل را نمایش میدهد.
بخشی که ارزش امتحانکردن دارد، «مهارتهای عامل» است. هر مهارت ابزاری در اختیار مدل میگذارد؛ برای نمونه، جستوجو در Wikipedia برای درستیسنجی، نقشهای تعاملی یا کارتی برای ارائهٔ چکیدهای دیداری. مهارتهای بیشتری را نیز میتوان از یک نشانی اینترنتی بارگذاری کرد. گوگل برنامه را «در حال توسعهٔ فعال» توصیف میکند و ناپختگیهای آن نیز این موضوع را نشان میدهند. این برنامه را با Gemini اشتباه نگیرید؛ Gemini محصولی جداگانه است.
مهارت Wikipedia را، که به اتصال اینترنت نیاز دارد، با چند پرسش درستیسنجی دربارهٔ مجموعهٔ «دوستان» آزمودم. Gemma ۴ هر بار صفحهٔ درست را پیدا کرد و چکیدههایش دقیق بودند. وقتی «حالت تفکر» را، که یکی از تنظیمات مدل است، روشن کردم، تقریباً همان اطلاعات را در قالبی متفاوت گرفتم و سرعت نیز بهسختی تغییر کرد. این قابلیت را میتوان در بخش گفتوگوی هوش مصنوعی روشن یا خاموش کرد و با فعالکردنش، فرایند استدلال درونی مدل مستقیماً به کاربر نمایش داده میشود.
انکلیو ایآی
گفتوگو با پروندههای پیدیاف، حتی در حالت هواپیما
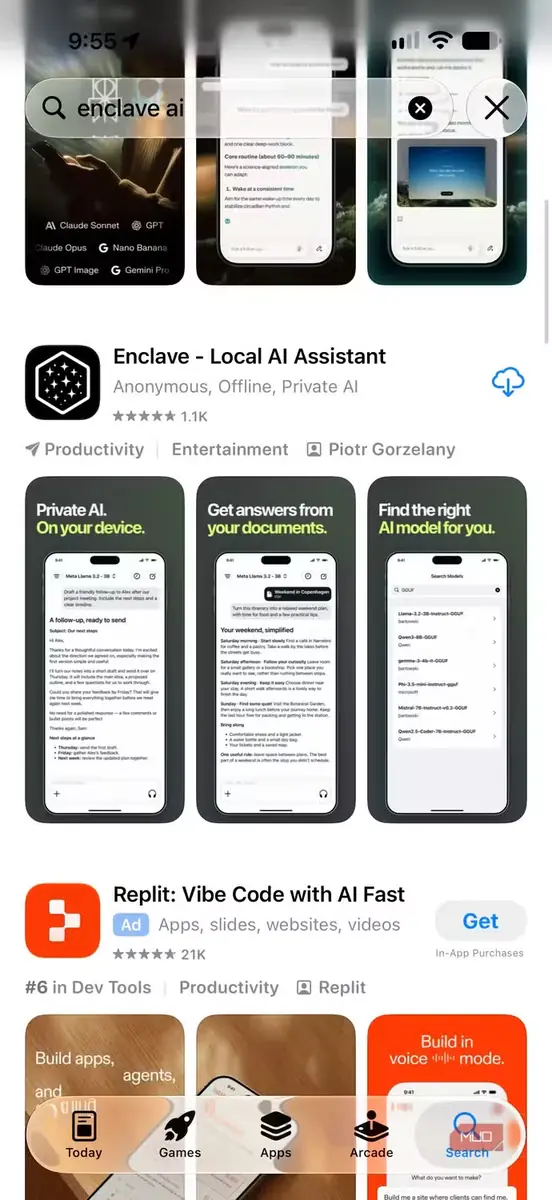
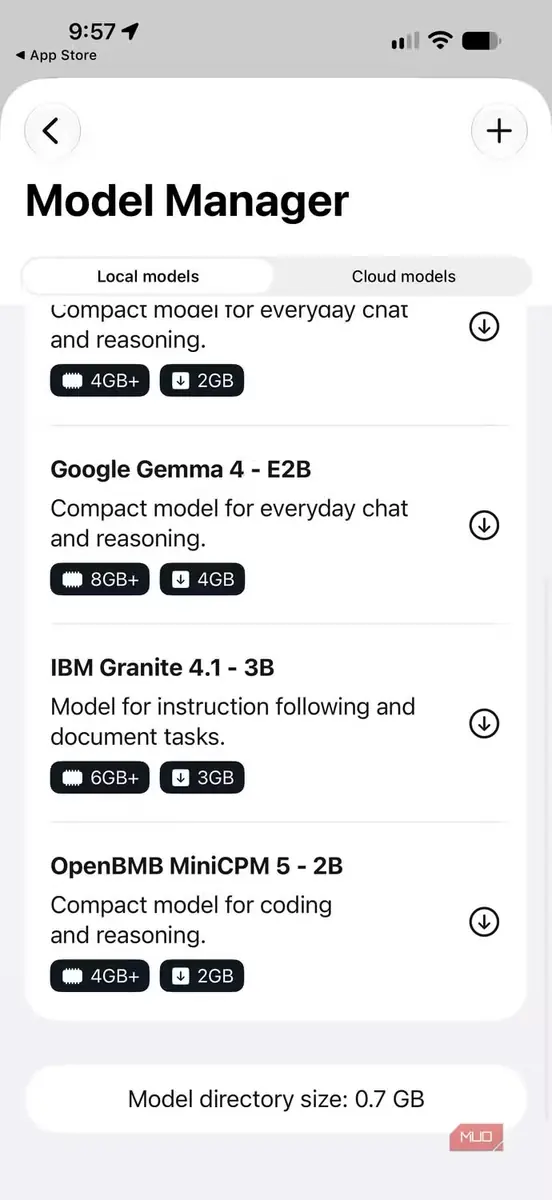
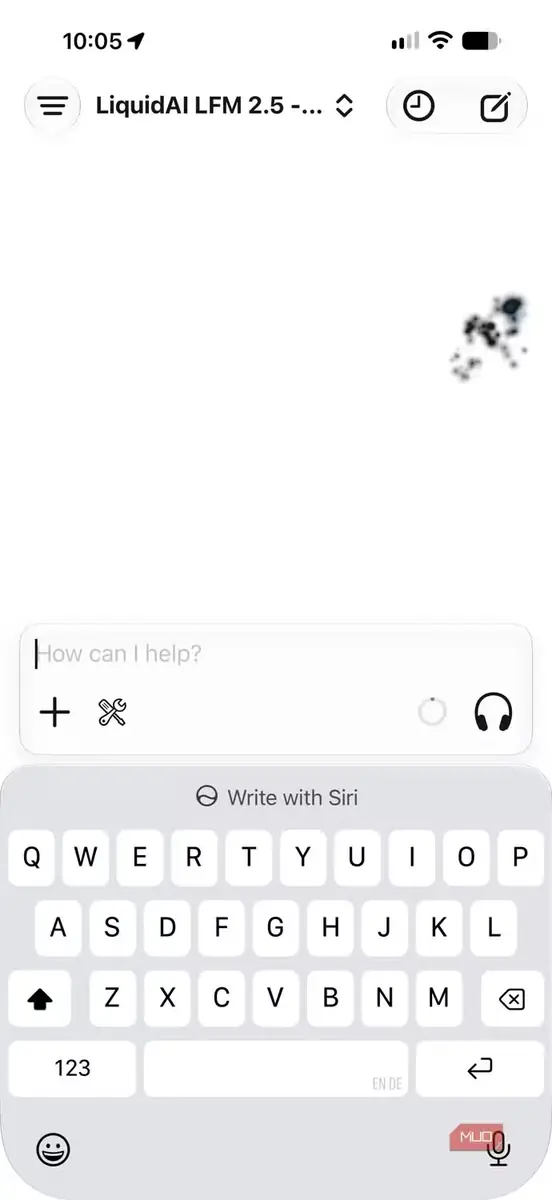
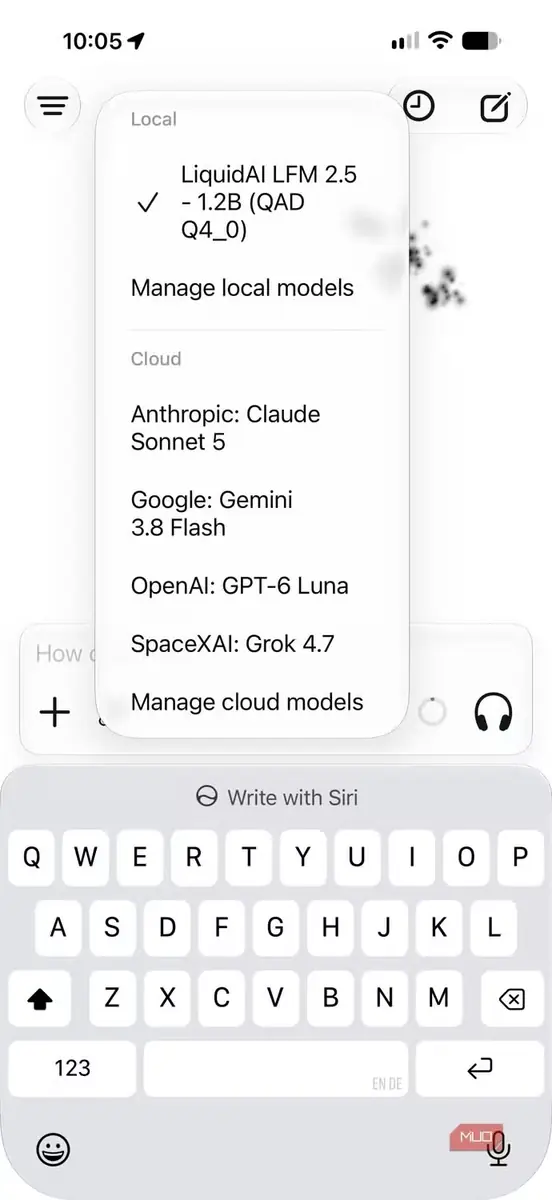
Enclave رایگان است، برای مدلهای بزرگتر خرید درونبرنامهای دارد و بر پایهٔ llama.cpp اجرا میشود. این برنامه دو کار مهم را که برایم کاربردیاند انجام میدهد: گفتوگوی صوتی محلی بدون اتصال اینترنت کار میکند و میتوان مستقیماً درون برنامه با سندها کار کرد. کنش میانبر «Ask Enclave» و پشتیبانی از Siri نیز در دسترس است.
Enclave میتواند به مدلهای ابری مانند Claude و Gemini نیز متصل شود. این قابلیت سودمند است، اما پیش از واردکردن هرگونه اطلاعات حساس، حتماً بررسی کنید کدام مدل انتخاب شده است.
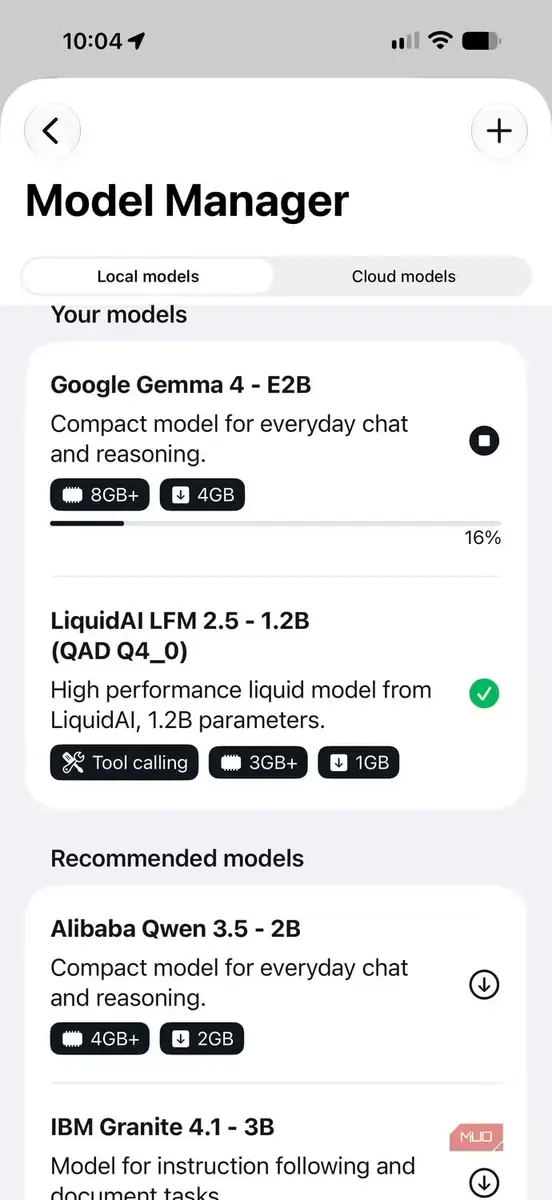
مدل Gemma ۴ E2B گوگل را، که دریافتش ۸ گیگابایت حجم داشت، در Enclave بارگذاری کردم و یک پروندهٔ PDF به آن دادم. پاسخها کمی دیرتر از دیگر برنامهها آماده میشدند، اما دقیق بودند و از بخشهای درست سند استخراج شده بودند. گفتوگوی صوتی نیز کار میکند. حالت هواپیما را روشن کردم و بدون هیچ اتصالی با برنامه حرف زدم؛ بااینحال، پاسخها با تأخیر میرسیدند و صدا بهشدت رباتگونه بود.
چگونه نخستین مدل خود را انتخاب کنیم
پارامتر، کوانتیزهسازی و حافظهٔ رم به زبان ساده
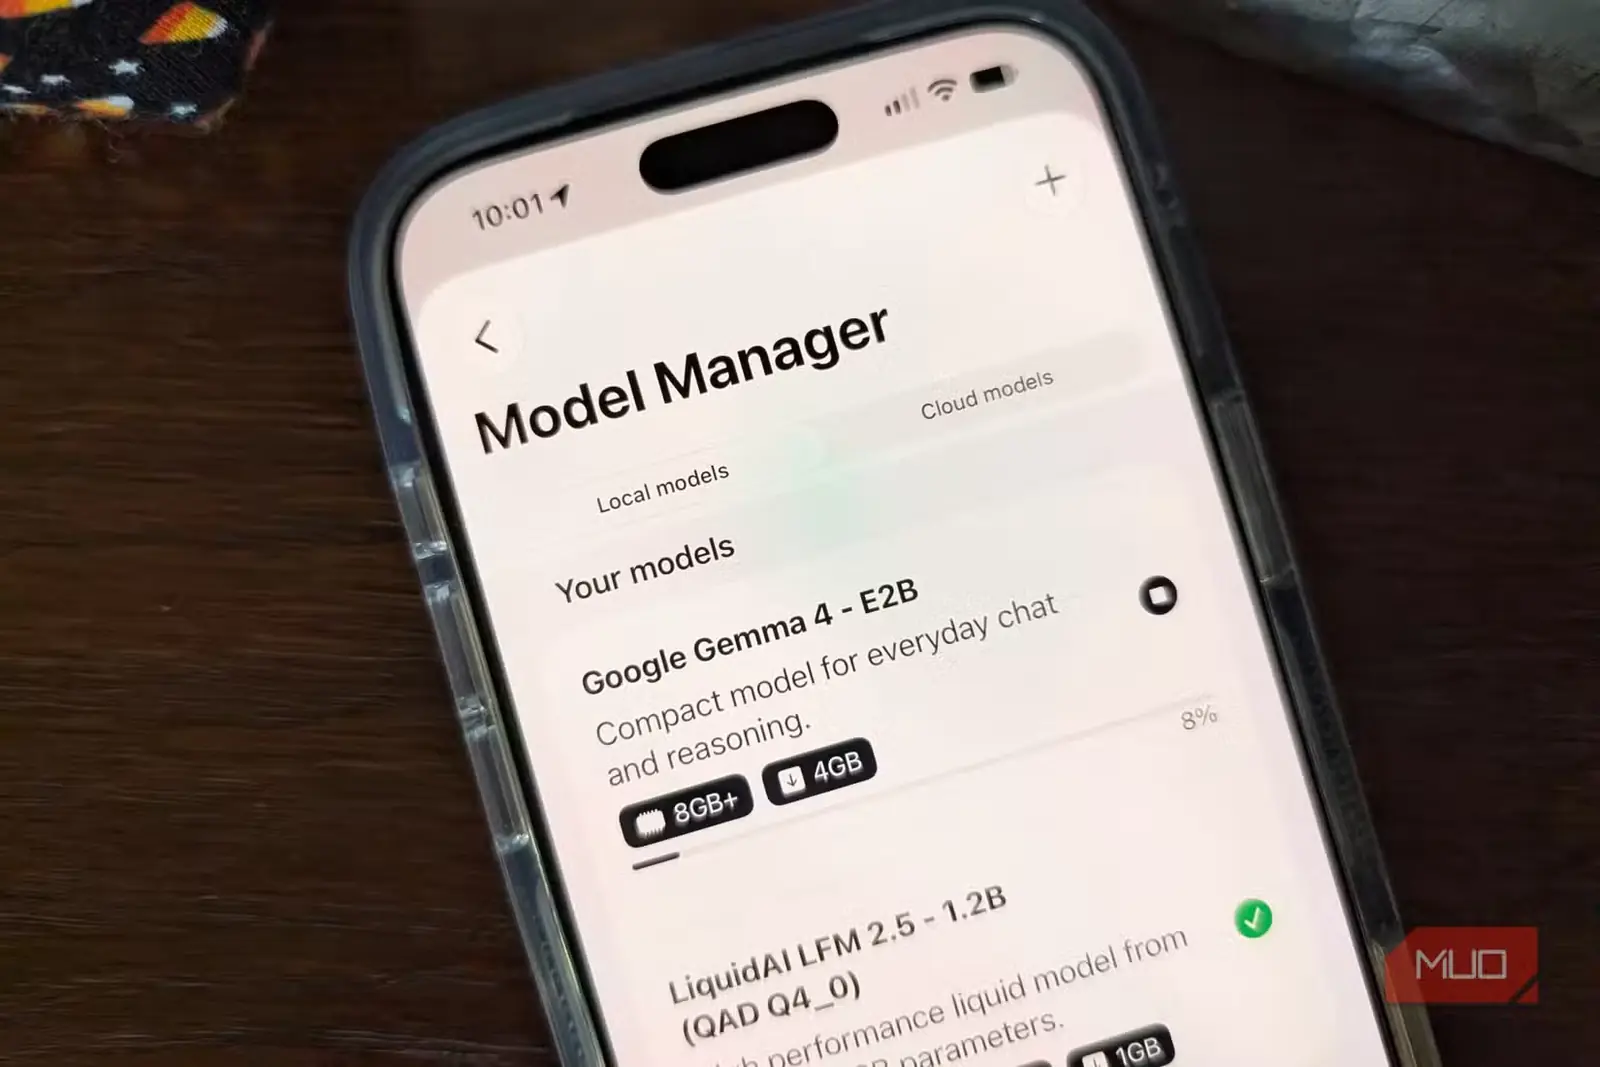
فهرست مدلها در این برنامهها در نگاه نخست گیجکننده است. با نامهایی مانند Gemma ۴ E2B و Qwen ۳.۵ 9B و نام پروندههایی روبهرو میشوید که به عباراتی مانند Q4_K_M ختم میشوند. من ابتدا همهٔ این جزئیات را نادیده میگرفتم و نخستین گزینهٔ فهرست را انتخاب میکردم. این روش تا زمانی مشکلی ندارد که مدلی بیش از اندازه بزرگ برای گوشیتان برگزینید.
ابتدا به عددی نگاه کنید که پس از آن حرف B آمده است. این عدد شمار پارامترهای مدل را بر حسب میلیارد نشان میدهد و میتوان آن را، با اندکی سادهسازی، معیاری از میزان آموختههای مدل در دورهٔ آموزش دانست. پارامترهای بیشتر معمولاً نگارش بهتر و دانش گستردهتری به همراه دارند، اما به حافظهٔ بیشتری نیاز دارند و پاسخگویی را کندتر میکنند. من Qwen ۳.۵ را در دو اندازه آزمودم. نسخهٔ 2B روی گوشیام تقریباً بیدرنگ پاسخ داد. نسخهٔ 9B که روی Mac اجرا میشد، کمی بیشتر زمان برد و مسیر متفاوتی را در پاسخ پیش گرفت. هر دو سودمند بودند. اگر تازه میخواهید این کار را روی iPhone آغاز کنید، مدلی میان 2B و 4B برگزینید.
موضوع بعدی کوانتیزهسازی است که در اصل میتوان آن را نوعی فشردهسازی برای مدلهای هوش مصنوعی دانست. اگر با PocketPal در Hugging Face جستوجو کنید، نام پروندههایی را میبینید که به Q4_K_M، Q5_K_M یا Q8_0 ختم میشوند. عدد پس از Q تقریباً نشان میدهد هر بخش از مدل چند بیت از دادهها را نگه میدارد. Q8 از همه به مدل اصلی نزدیکتر است و بیشترین فضا را اشغال میکند. Q4 تقریباً نصف آن حجم دارد، اما افت کیفیتش کمتر از چیزی است که انتظار دارید. برای گوشی، معمولاً Q4_K_M بهترین گزینه برای دریافت است. به همین دلیل، همان مدل Gemma ۴ E2B در PocketPal حجمی ۴ گیگابایتی و در Enclave حجمی ۸ گیگابایتی داشت.
در پایان، میزان حافظهٔ دستگاه را بررسی کنید. اپل مقدار RAM را در برگههای مشخصات فنی درج نمیکند؛ بنابراین پیش از دریافت پروندهای حجیم، مشخصات مدل گوشی خود را جستوجو کنید. iOS و دیگر برنامهها نیز به بخشی از حافظه نیاز دارند، پس پروندهای را انتخاب کنید که چند گیگابایت از کل حافظهٔ گوشی کوچکتر باشد. نسخهٔ ۸ گیگابایتی Gemma روی گوشی ۱۲ گیگابایتی من اجرا شد، اما در میان همهٔ گزینههایی که آزمودم، کندترین بود.
حواستان به فضای ذخیرهسازی هم باشد. هر برنامهٔ iOS فایلهایش را جداگانه نگه میدارد؛ بنابراین اگر سه برنامه را امتحان کنید، همان مدل را سه بار بارگیری خواهید کرد. خودم تا وقتی فضای ذخیرهسازی گوشی را بررسی نکرده بودم به این موضوع فکر نکرده بودم؛ آنجا دیدم Gemma ۴ در چهار جای مختلف گوشیام جا خوش کرده و حجم زیادی از فضا را میبلعد.
مدلهای محلی در مقایسه با ChatGPT یا Claude دانش کمتری هم دارند و نمیتوانند بهصورت زنده به وب دسترسی پیدا کنند، مگر اینکه برنامه ابزاری برای این کار در اختیارشان بگذارد. من هنوز برای پژوهش از اشتراکهای پولیام استفاده میکنم. در حال حاضر، مدلهای محلی کارهای سریع را برایم انجام میدهند؛ مثل مرتبکردن یادداشتها و هر چیزی که ترجیح میدهم بارگذاریاش نکنم.
منبع: این مطلب ترجمه و بومیسازی مقالهای از MakeUseOf به قلم Bryan M. Wolfe است. مشاهده مقاله اصلی