اجرای محلی مدلهای زبانی بزرگ معمولاً به کارت گرافیک مجزا و نیرومندی نیاز دارد تا از پس این حجم پردازش برآید. هرچند از نظر فنی میتوان یک LLM را با پردازنده مرکزی هم اجرا کرد، سرعت آن همچنان بهمراتب کمتر از چیزی است که با یک کارت گرافیک مناسب به دست میآورید.
اینجاست که به قلمرو عجیب گرافیکهای یکپارچه میرسیم. این APUها بههیچوجه همرده پردازندههای گرافیکی دسکتاپ نیستند، اما از نظر فنی همچنان GPU به شمار میآیند؛ پس در نظریه میتوان مدلهای زبانی بزرگ را بهصورت محلی روی آنها نیز اجرا کرد. برای یافتن پاسخ، سراغ میز آزمایش رفتم و سه سامانه مجهز به iGPU را برای بررسی آماده کردم.
نگاهی به سامانههای آزمایش
سه دستگاه از سه نسل متفاوت گرافیک یکپارچه
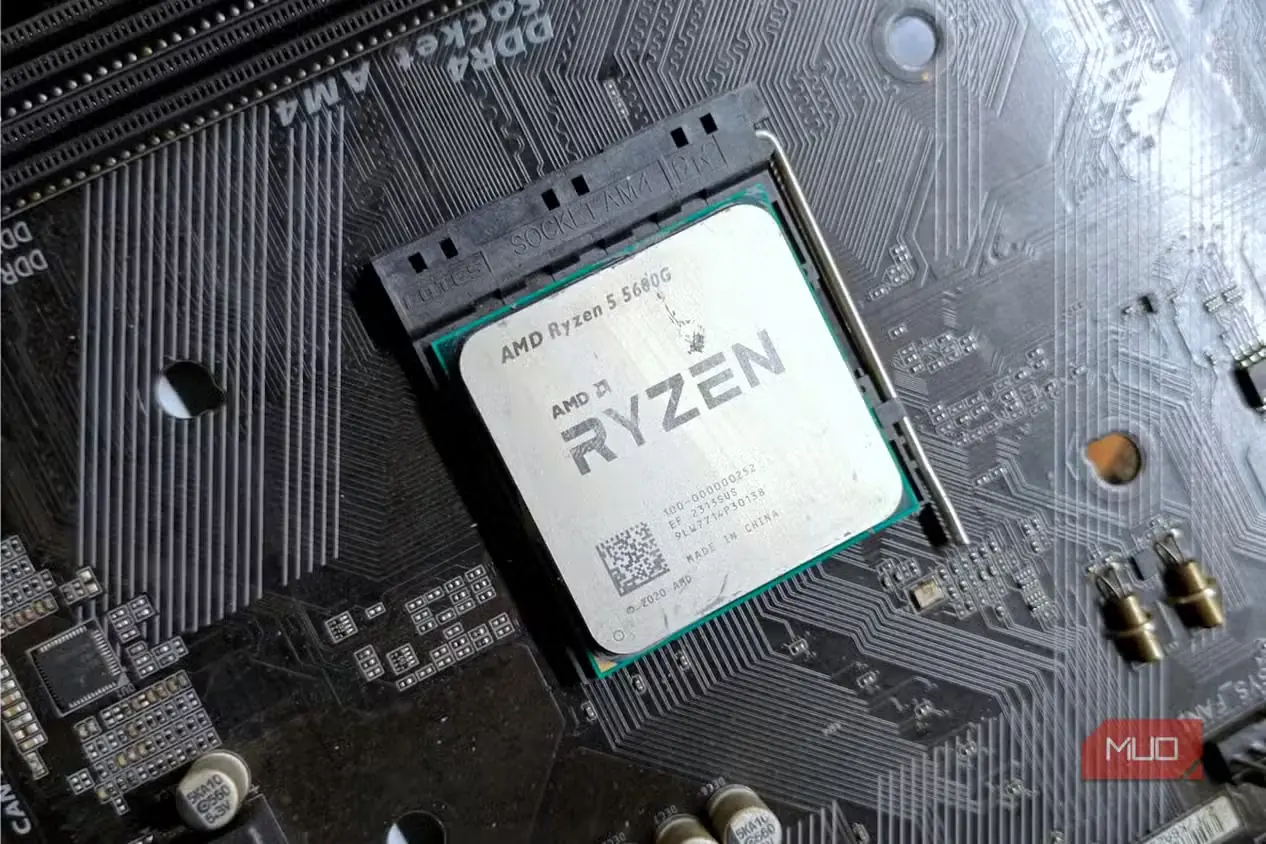
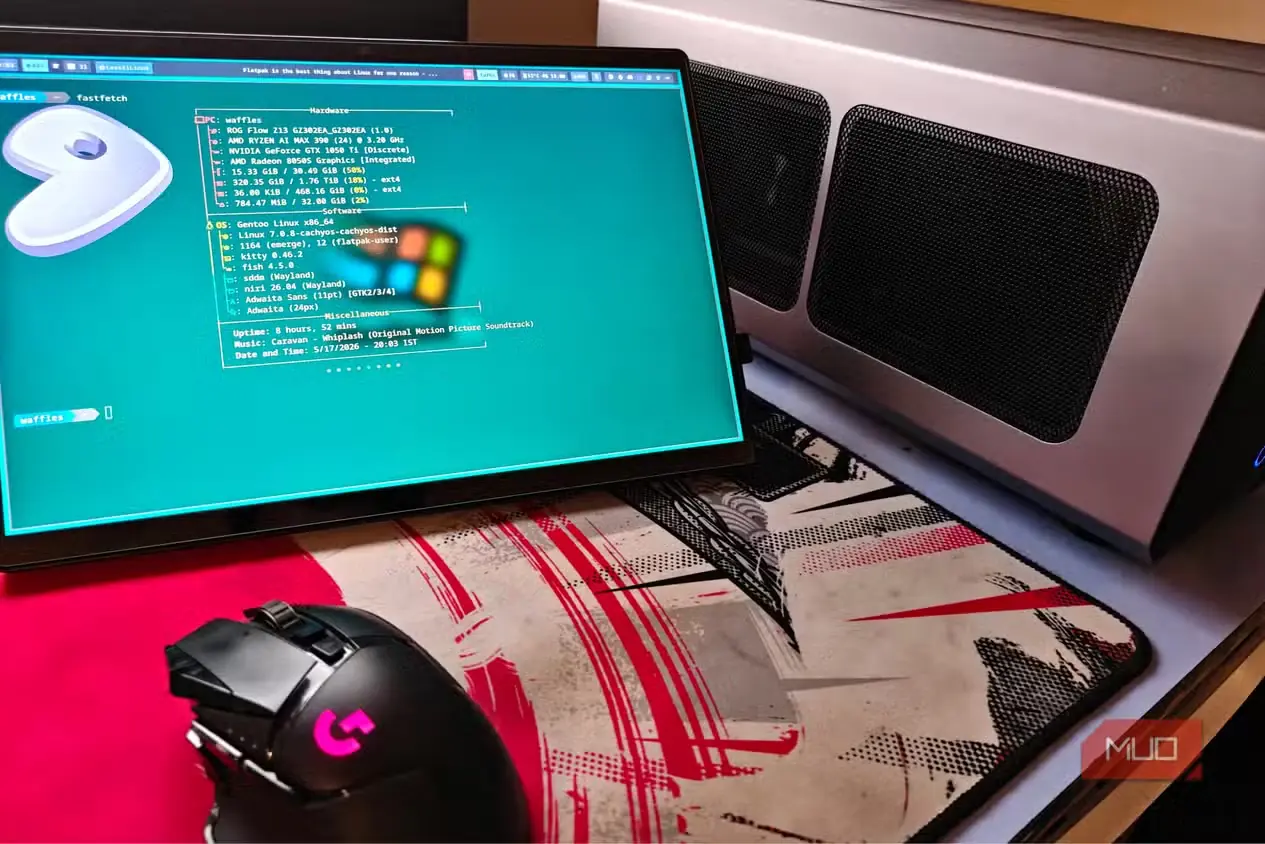
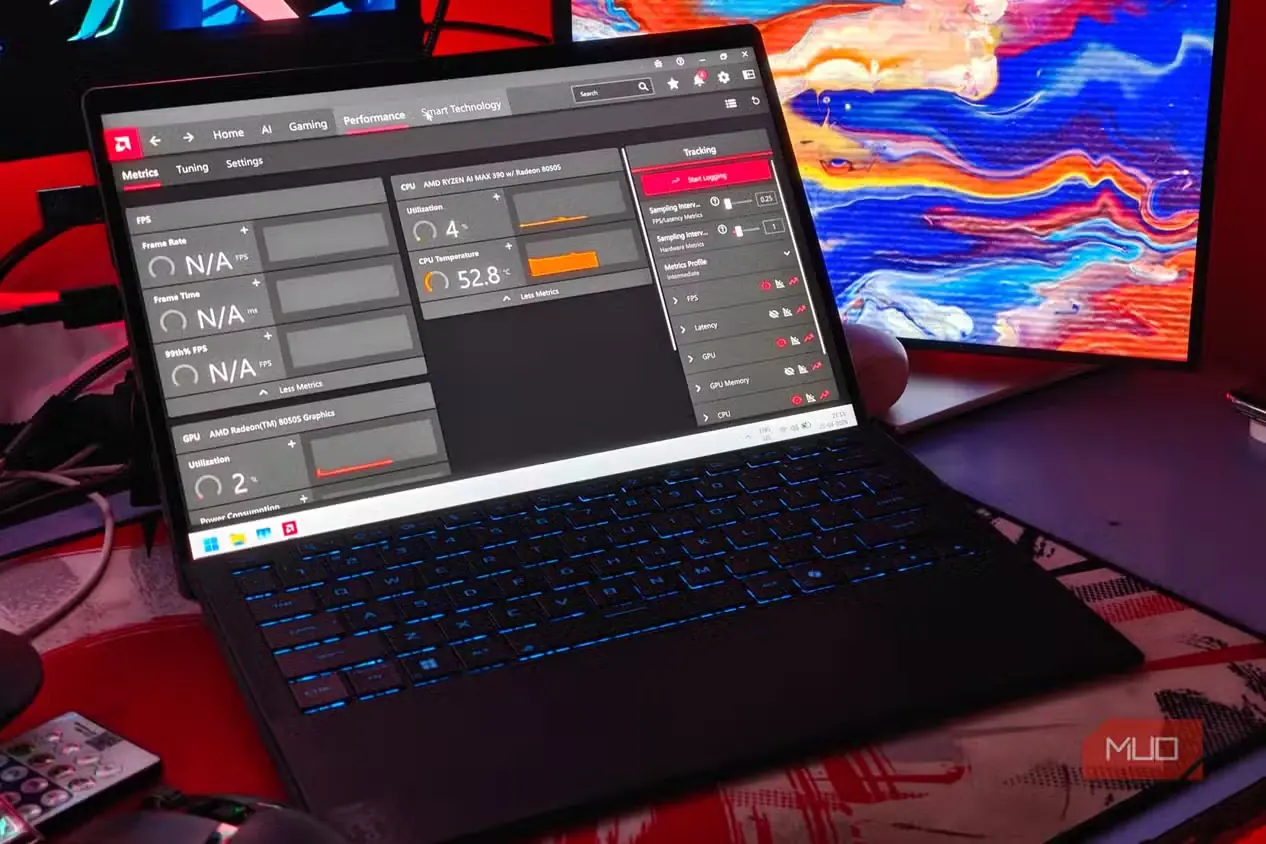
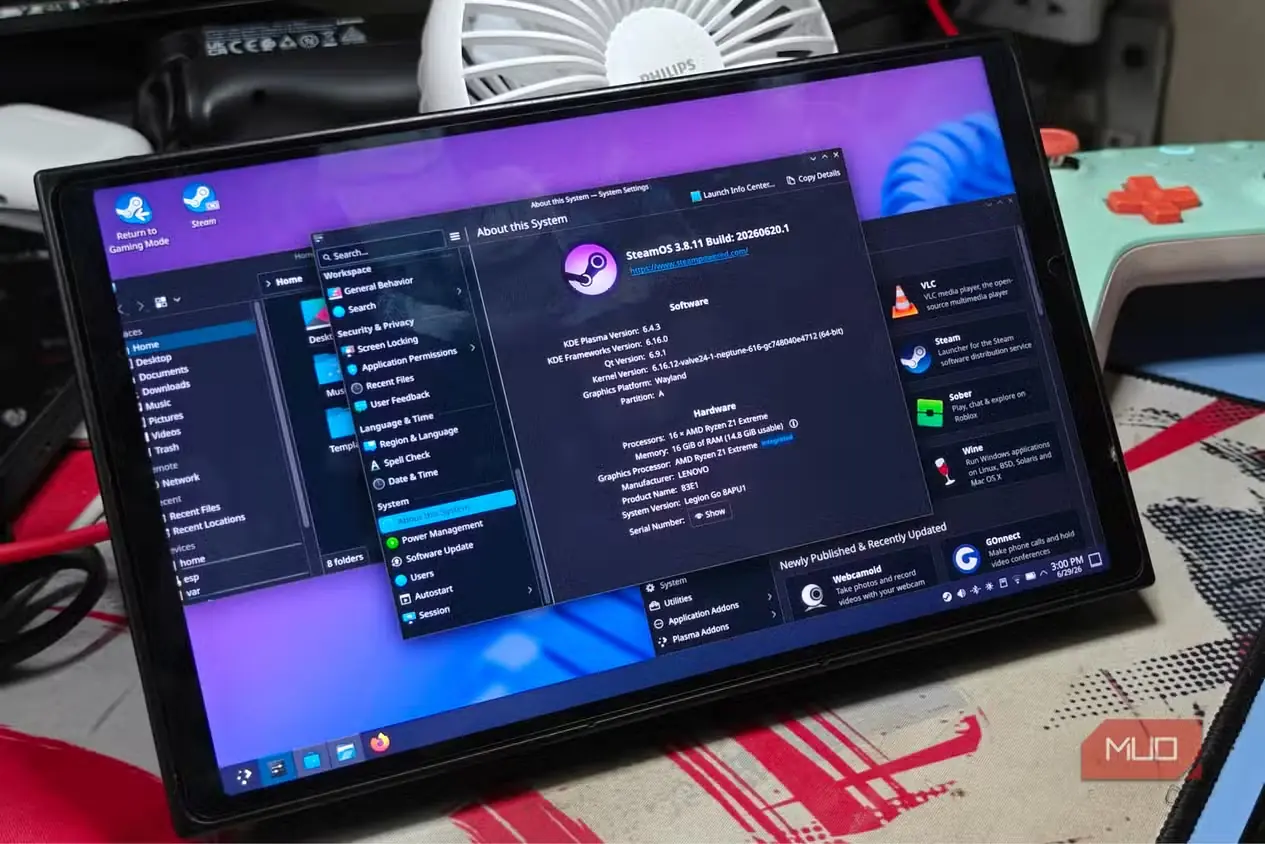
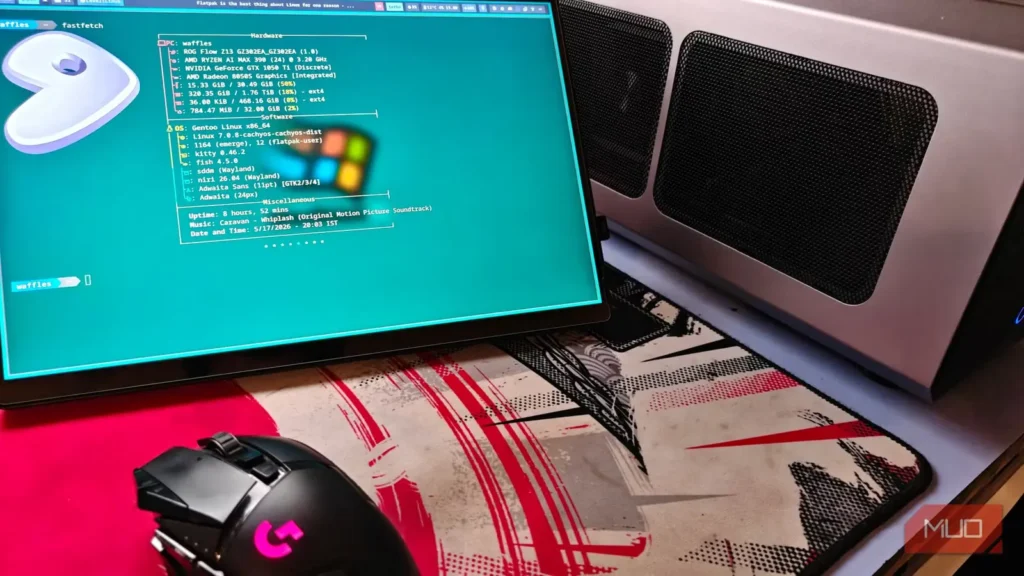
در این آزمایش از سه دستگاه استفاده شد: ROG Flow Z13 با AI Max ۳۹۰ و ۳۲ گیگابایت حافظه، نسل نخست Legion Go مجهز به Ryzen Z1 Extreme و ۱۶ گیگابایت رم، و در نهایت گرافیک یکپارچه ساده Vega ۷ در Ryzen ۵ 5600G.
هر یک از این گرافیکهای یکپارچه گامی رو به جلو و نماینده مرحلهای از تکامل این فناوری است. AI Max ۳۹۰ یک APU نیرومند با پردازندهای ۱۲ هستهای و ۲۴ رشتهای است که در کنار یکی از سریعترین iGPUهای بازار مصرفی قرار گرفته؛ ترکیبی که آن را به یکی از بهترین مجموعههای سختافزاری قابل خرید در حال حاضر بدل میکند.
مدلی که من در اختیار دارم تنها ۳۲ گیگابایت حافظه سیستم دارد و همین موضوع دامنه مدلهای قابل اجرا روی آن را محدود میکند. بااینحال، این دستگاه نمایی از یکی از بهترین ترکیبهای سختافزاری کنونی برای هوش مصنوعی محلی به دست میدهد و بهگمانم بهخوبی از پس انتظارات برمیآید.
دستگاه بعدی، نسل نخست Lenovo Legion Go است؛ یکی از رایانههای دستی متعددی که با پردازنده AMD Ryzen Z1 Extreme برای رقابت با Steam Deck به میدان آمدند. توانایی آن کاملاً قابلقبول است، اما بههیچوجه به پای 8050S در Flow Z13 نمیرسد. افزون بر این، حافظه ۱۶ گیگابایتی سیستم نیز در اینجا محدودمان خواهد کرد.
بااینهمه، همین دستگاه نیز چندین سر و گردن بالاتر از آخرین گزینه فهرست قرار میگیرد: گرافیک یکپارچه Vega ۷ در Ryzen ۵ 5600G. این تراشه زمانی انتخابی فوقالعاده بود، اما دوران اوجش مدتهاست به پایان رسیده است.
این گزینه در نگاه نخست شاید بیشتر به یک شوخی شبیه باشد، اما واقعاً میتوان مدلهای زبانی بزرگ امروزی را، البته با محدودیتهای سختافزاری همیشگی، روی چنین معماریهای گرافیکی قدیمی اجرا کرد. گذشته از این، آزمایش سرگرمکنندهای هم از آب درمیآید.
آمادهسازی بستر آزمایش
نکتهها، ترفندها و دردسرهای فراوان برای 5600G
روش آزمایش ساده بود: اجرای یک آزمون سنجش LLM بر پایه چند معیار، با اسکریپتهایی که به کمک Claude ساخته و تکمیل شدند. آزمایشها روی هر سه دستگاه انجام گرفتند و هدف این بود که از تمام منابع در دسترس هر دستگاه استفاده شود.
این کار به مصرف بیشتر VRAM میانجامد؛ هرچند خیلی زود روشن میشود که اگر iGPU به کندی شیره حرکت کند، این افزایش حافظه چندان اهمیتی ندارد.
راهاندازی 5600G کمی دردسرساز بود. گرافیک یکپارچه Vega ۷ با شناسه gfx90c بهطور رسمی از ROCm پشتیبانی نمیکند؛ بنابراین برای دستیابی به نتیجه و سازگاری بهتر، استفاده از بخش پشتیبان Vulkan انتخاب مناسبتری است.
| معیار | Ryzen ۵ 5600G با گرافیک یکپارچه Vega ۷ | Z1 Extreme با پردازنده مرکزی | Z1 Extreme با گرافیک یکپارچه 780M | AI MAX ۳۹۰ با گرافیک یکپارچه 8050S |
|---|---|---|---|---|
| سرعت تولید (توکن بر ثانیه) | 17.5 | 22.4 | 44.1 | 85.1 |
| پردازش فرمان ورودی (توکن بر ثانیه) | 201 | 150 | 783 | 1,609 |
| زمان هر اجرا (ثانیه) | 16.8 | 13.7 | 6.3 | 3.2 |
| میانگین توان مصرفی (وات) | 41 | 18 | 33 | 64 |
| بهرهوری (توکن بر ثانیه بهازای هر وات) | 0.43 | 1.25 | 1.34 | 1.33 |
| بیشینه دما (درجه سلسیوس) | 57 | 64 | 81 | 95 |
همچنین ناچار شدم از طریق BIOS، مقدار ۱۶ گیگابایت VRAM را بهصورت دستی به iGPU اختصاص دهم که بیشترین حد قابل تنظیم بود. این کار باید هرگونه گلوگاه ناشی از VRAM را برطرف کند، هرچند همانطور که بهزودی خواهید دید، تفاوت چندانی ایجاد نمیکند.
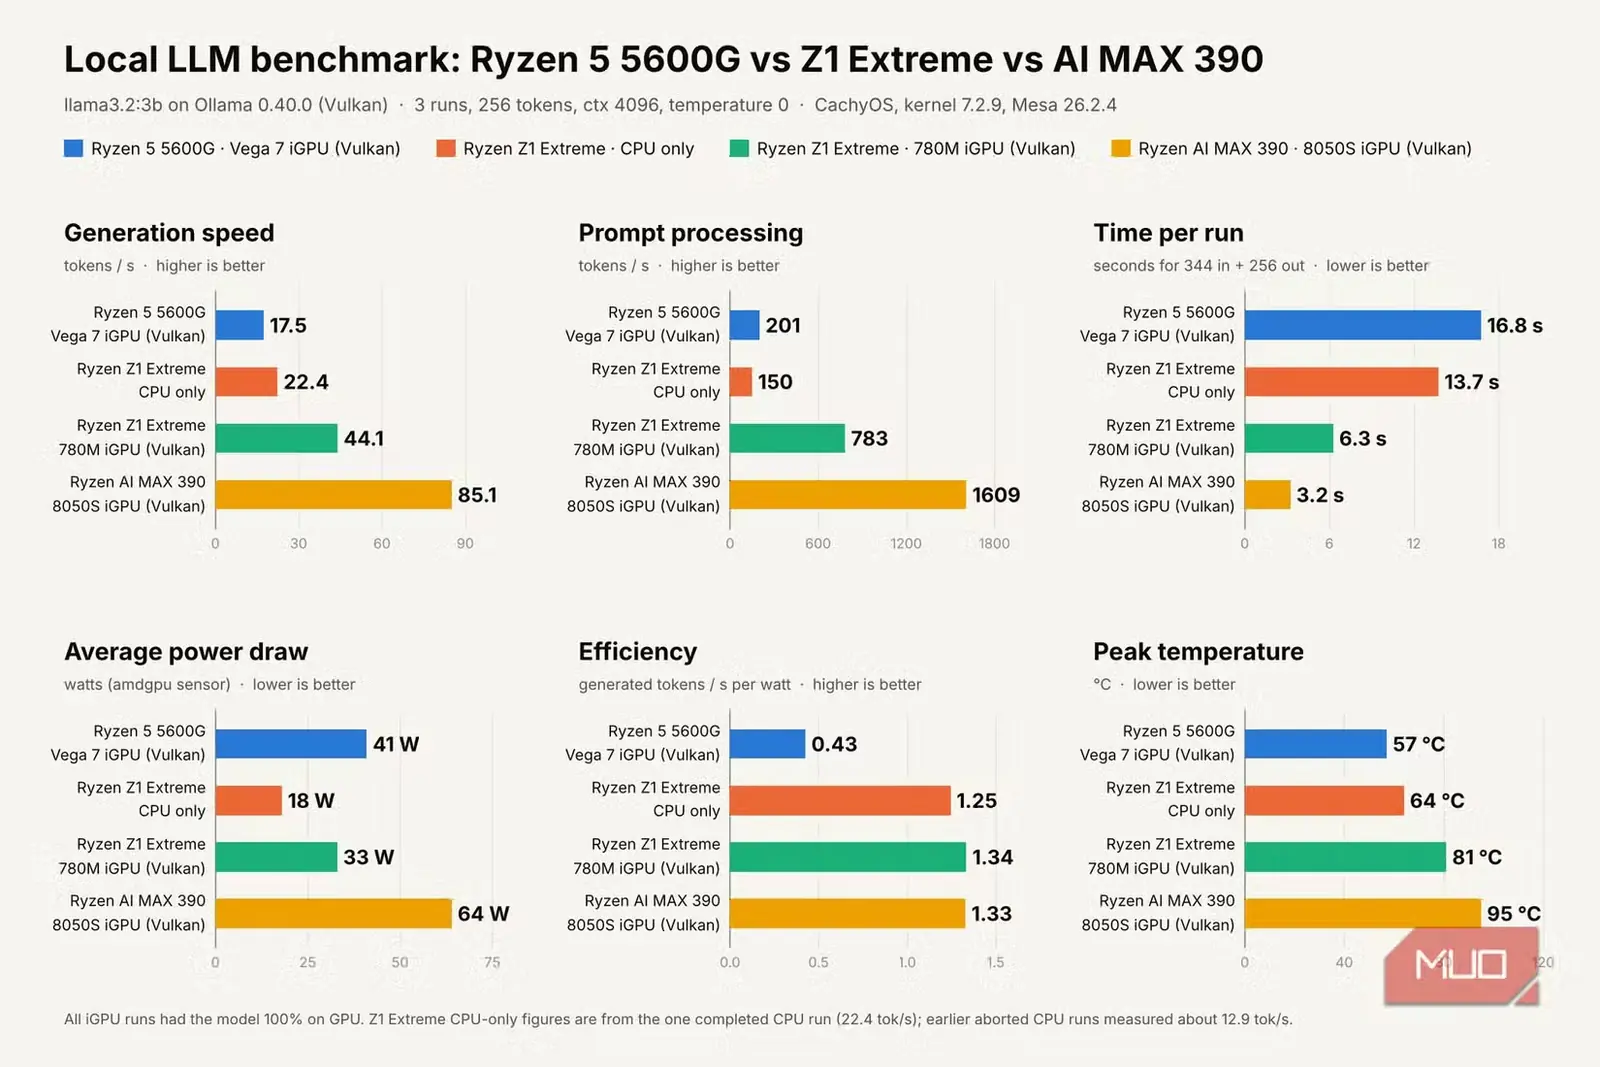
حالا اگر به نتایج آزمون برگردیم، مجموعه تقریباً همانطور عمل کرد که انتظار میرفت؛ بااینحال، چند نکته جالب هم به چشم میخورد. جای شگفتی نیست که AI Max ۳۹۰ بهترین عملکرد را داشت و با اختلافی چشمگیر در صدر جدول ایستاد. بههرحال، 8050S میتواند همپای نسخه همراه RTX ۴۰۶۰ پیش برود و از مزیت حافظه گرافیکی بیشتر و سریعتر نیز بهره میبرد.
پس از آن، Ryzen Z1 Extreme قرار میگیرد که تقریباً دو برابر کندتر است. بااینهمه، پردازنده گرافیکی یکپارچه 780M توانست به نرخ تولید ۴۴.۱ توکنبرثانیه برسد که نتیجه چندان بدی نیست.
و سرانجام به پردازنده گرافیکی یکپارچه Vega ۷ در Ryzen ۵ 5600G میرسیم که مطابق انتظار، کندترین عملکرد را داشت. این پردازنده با نرخ تولید ۱۷.۵ توکنبرثانیه، نزدیک به ۵ برابر از AI Max ۳۹۰ کندتر است. مصرف برق آن نیز کم نیست و بدون آنکه نتیجه چشمگیری ارائه دهد، در اوج به ۴۱ W میرسد.
هرچند 5600G غول پردازشی نیست، همچنان تا اندازهای از پس اجرای محلی مدلهای زبانی بزرگ برمیآید. چه آن را کنجکاوی بیمارگونه بنامیم و چه میل به کشف ناشناختهها، همین که سختافزاری با این قدمت اصولاً میتواند چنین مدلی را اجرا کند، در نوع خود شگفتانگیز است.
از نظر فنی میتوان ROCm را روی پردازندههای گرافیکی پشتیبانینشده اجرا کرد، اما این کار تفاوتی در نتیجه ایجاد نمیکند. به نظر میرسد Ollama نیز در حالت پیشفرض چندان با پردازندههای گرافیکی یکپارچه سازگار نیست و ناچار شدم پرونده پیکربندی را متناسب با آن تغییر دهم.
آینده هوش مصنوعی محلی در گرو گرافیک یکپارچه و حافظه یکپارچه است
AI Max ۳۹۰ در این آزمون همه رقبا را قاطعانه پشت سر میگذارد و حتی میتواند با برخی پردازندههای گرافیکی رومیزی شانهبهشانه شود. بااینحال، یک چالش بزرگ و انکارناپذیر وجود دارد: قیمت.
دستگاههای مجهز به Ryzen AI Max بسیار گراناند و بههیچوجه در دسترس همگان قرار ندارند؛ بااینحال، توان پردازشی و پشتیبانی جامعه کاربران آنها بیتردید چشمگیر است. ترکیب این ویژگیها با حافظه یکپارچه سریعِ رویبرد ــ که متأسفانه لحیم شده است ــ چنین دستگاههایی را به گزینهای آرمانی برای هوش مصنوعی محلی بدل میکند؛ حوزهای که بهسرعت در حال تبدیل شدن به یکی از دستههای محبوب فناوری برای من است.
منبع: این مطلب ترجمه و بومیسازی مقالهای از MakeUseOf به قلم Dipan Saha است. مشاهده مقاله اصلی