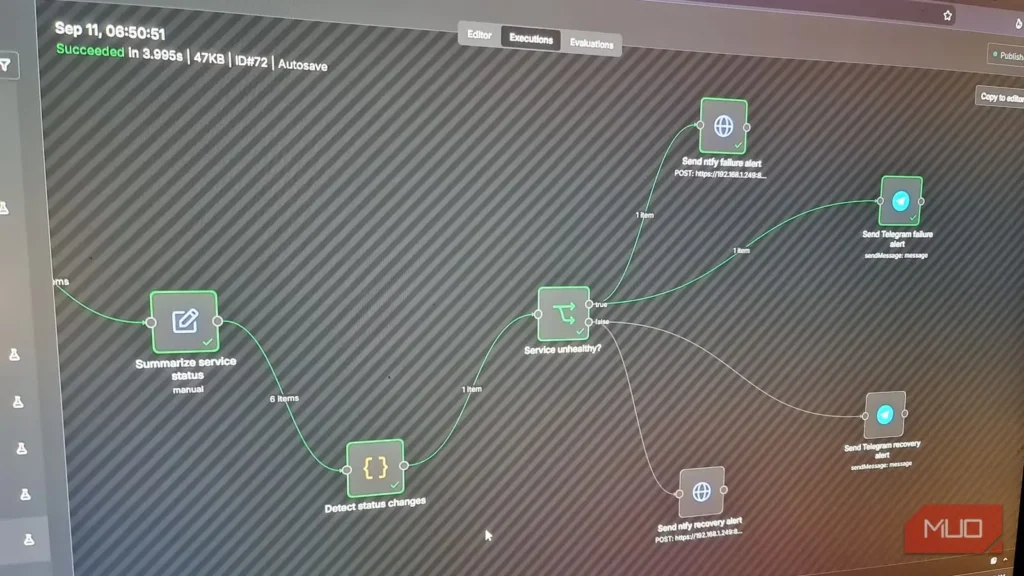
برای زیر نظر داشتن همهچیز، داشبورد هومار (Homarr) را روی سرور آزمایشگاه خانگیام نصب کردم. اما مطابق رسم همیشگی آزمایشگاههای خانگی، داشبورد را ساختم، تحسینش کردم و بعد دیگر هرگز سراغش نرفتم. این کار یک مشکل آشکار داشت: صفحهٔ وضعیت وقتی بیاستفاده روی همان سروری مانده که قرار است پایش کند، عملاً نمیتواند دربارهٔ هیچ مشکلی به من هشدار بدهد.
در زمینهٔ ابزارهای خودکارسازی دیداری هم کمی از زمانه عقب مانده بودم، چون نوشتن اسکریپت برایم راحتتر از چیدن یک گردشکار دیداری است. پس از بررسی مِیک (Make) و اِناِیتاِن (n8n)، دومی را برگزیدم؛ چون نرمافزاری با مجوز «کد منصفانه» بود و میتوانست روی سختافزار خودم اجرا شود.
آن را روی یک رایانهٔ کوچک جداگانه نصب کردم و به آن یاد دادم شش سرویس را بررسی کند، پس از ناکامی دوباره تلاش کند، در تلگرام هشدار بفرستد و هر روز گزارشی از سلامت سامانه ارائه دهد.
نگهبان را بیرون از سروری گذاشتم که زیر نظر دارد
سامانهٔ پایش باید از خرابیهایی که گزارش میکند جان سالم به در ببرد
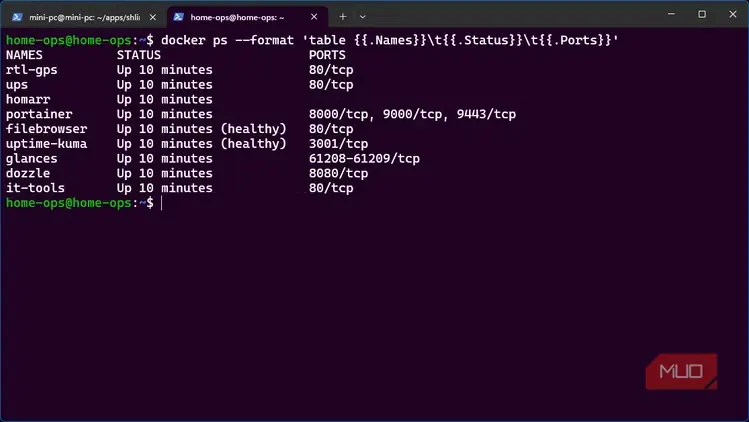
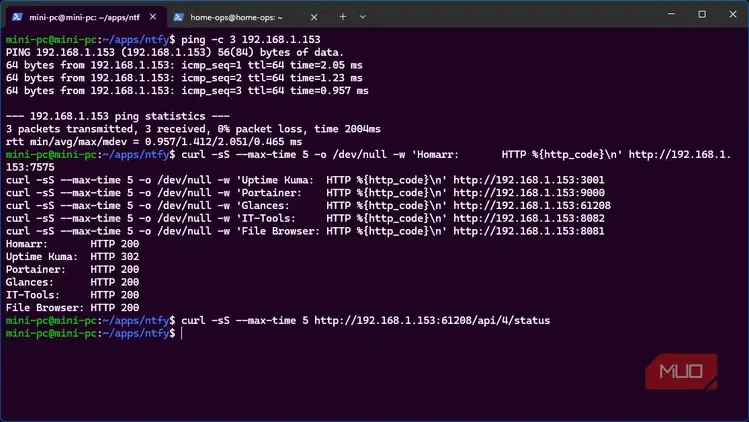
سرور هومآپس (Home Ops) من از همان ابتدا بهترین گزینه برای آزمایش بهعنوان هدف پایش بود. این سرور یک ماشین مجازی اوبونتو است که از طریق آداپتوری با نشانی آیپی 192.168.1.153 به شبکهٔ محلی دسترسی دارد. این سرور اکنون میزبان ۹ کانتینر است:
- داشبورد هومار (Homarr)
- آپتایم کوما (Uptime Kuma)
- پورتینر (Portainer)
- گلنسز (Glances)
- مرورگر پرونده (File Browser)
- دازل (Dozzle)
- ابزارهای فناوری اطلاعات (IT-Tools)
- پایش باتری یوپیاس (UPS)
- رابط اتصال به یک پروژهٔ رادیویی سرگرمی
واقعاً نمیخواستم نگهبان آزمایشگاه خانگی روی همان ماشین مجازی میزبانی شود. اگر ماشین از کار میافتاد یا پشتهٔ داکر خراب میشد، قرار دادن سامانهٔ هشدار درون آن فقط باعث میشد همهچیز یکجا فروبپاشد.
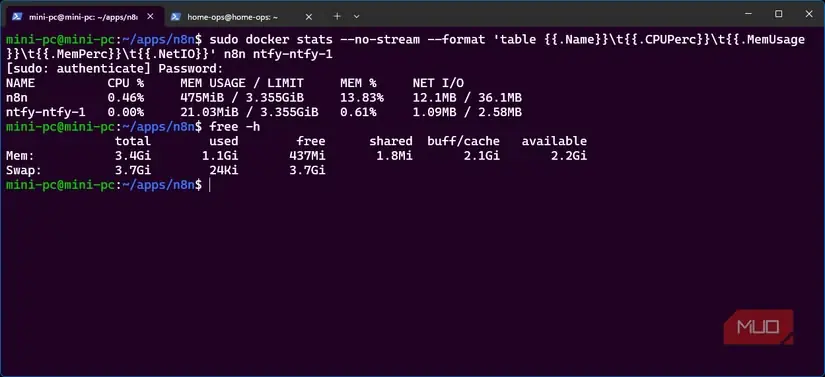
بنابراین اِناِیتاِن (n8n) را در کنار اِنتیفای (ntfy)، روی رایانهٔ کوچک دیگری نصب کردم که از پیش سرویسهایی را اجرا میکرد و در نشانی 192.168.1.249 مستقل از سرور هومآپس بود.
بهجای استفاده از latest، اِناِیتاِن را روی نسخهٔ ۲.۳۸.۶ ثابت نگه داشتم. پوشهٔ دادههای آن را به میزبان نگاشت کردم تا اگر لازم شد کانتینر جایگزین شود، گردشکارها و اطلاعات ورود همچنان باقی بمانند:
Services:
n8n:
     image: docker.n8n.io/n8nio/n8n:2.38.6
     restart: unless-stopped
     ports:
         - "127.0.0.1:5678:5678"
     volumes:
        - ./data:/home/node/.n8n
درگاه 5678 را به میزبان محلی محدود کردم تا مستقیماً در معرض شبکهٔ محلی نباشد. کدی (Caddy) همهٔ اتصالهای مرورگر را مدیریت میکرد و اِناِیتاِن را از طریق اچتیتیپیاس داخلی روی درگاه 8449 در دسترس میگذاشت. اکنون سامانهٔ پایش جدا، ماندگار و در دسترس بود.
گردشکار همهچیز را میسنجد، اما فقط هنگام تغییر وضعیت خبر میدهد
پایش پنجدقیقهای بدون تلاش دوباره و حافظه تحملناپذیر بود
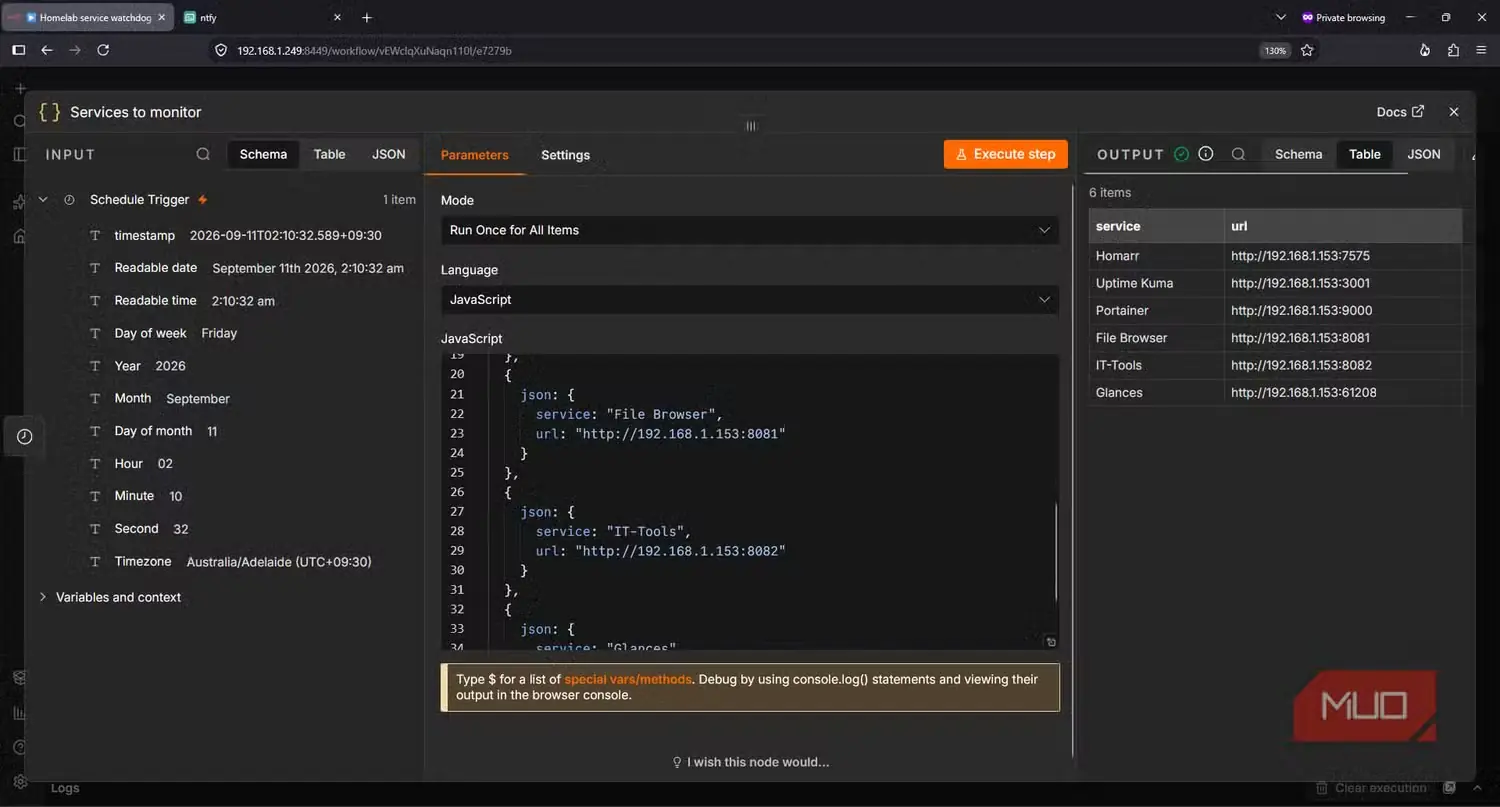
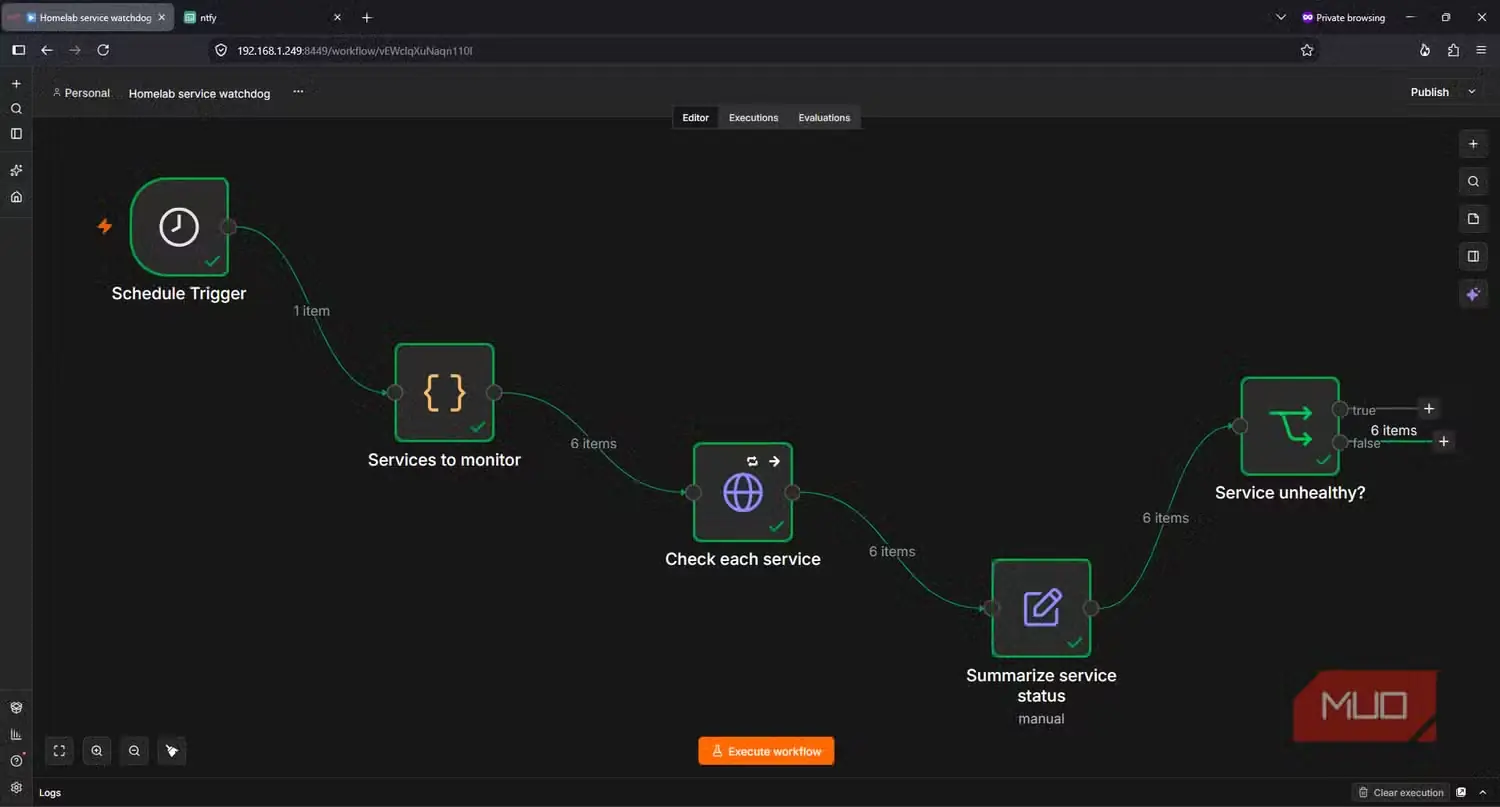
خودکارسازی را با یک «راهانداز زمانبندیشده» (Schedule Trigger) آغاز کردم که هر پنج دقیقه اجرا میشود. نخستین گرهٔ «کد» (Code) شش مورد میسازد که هرکدام نام یک سرویس و نشانی وبی را در خود دارند که اِناِیتاِن باید درخواست کند. نگهداشتن این اطلاعات در یک بلوک، افزودن یا حذف سرویسها را بسیار آسانتر از تکثیر گرهٔ اولیهٔ اچتیتیپی برای تکتک برنامهها میکرد:
return [
   { json: { service: "Homarr", url: "http://192.168.1.153:7575" } },
   { json: { service: "Uptime Kuma", url: "http://192.168.1.153:3001" } },
   { json: { service: "Portainer", url: "http://192.168.1.153:9000" } },
   { json: { service: "File Browser", url: "http://192.168.1.153:8081" } },
   { json: { service: "IT-Tools", url: "http://192.168.1.153:8082" } },
   { json: { service: "Glances", url: "http://192.168.1.153:61208" } }
];
سپس اِناِیتاِن این موارد را از یک گرهٔ واحد «درخواست اچتیتیپی» (HTTP Request) عبور میدهد. برای هر درخواست، تنظیمات زیر را در نظر گرفتم:
- مهلت انتظار پنجثانیهای.
- دو تلاش دوباره.
- پیروی از تغییرمسیرها.
- گزینهٔ «هرگز خطا نده».
تنظیم «هرگز خطا نده» (Never Error) برای این بود که در دسترس نبودن یک سرویس به دادهای تبدیل شود که گردشکار همچنان بتواند آن را ارزیابی کند، نه خطایی که اجرای فرایند را همانجا متوقف سازد.
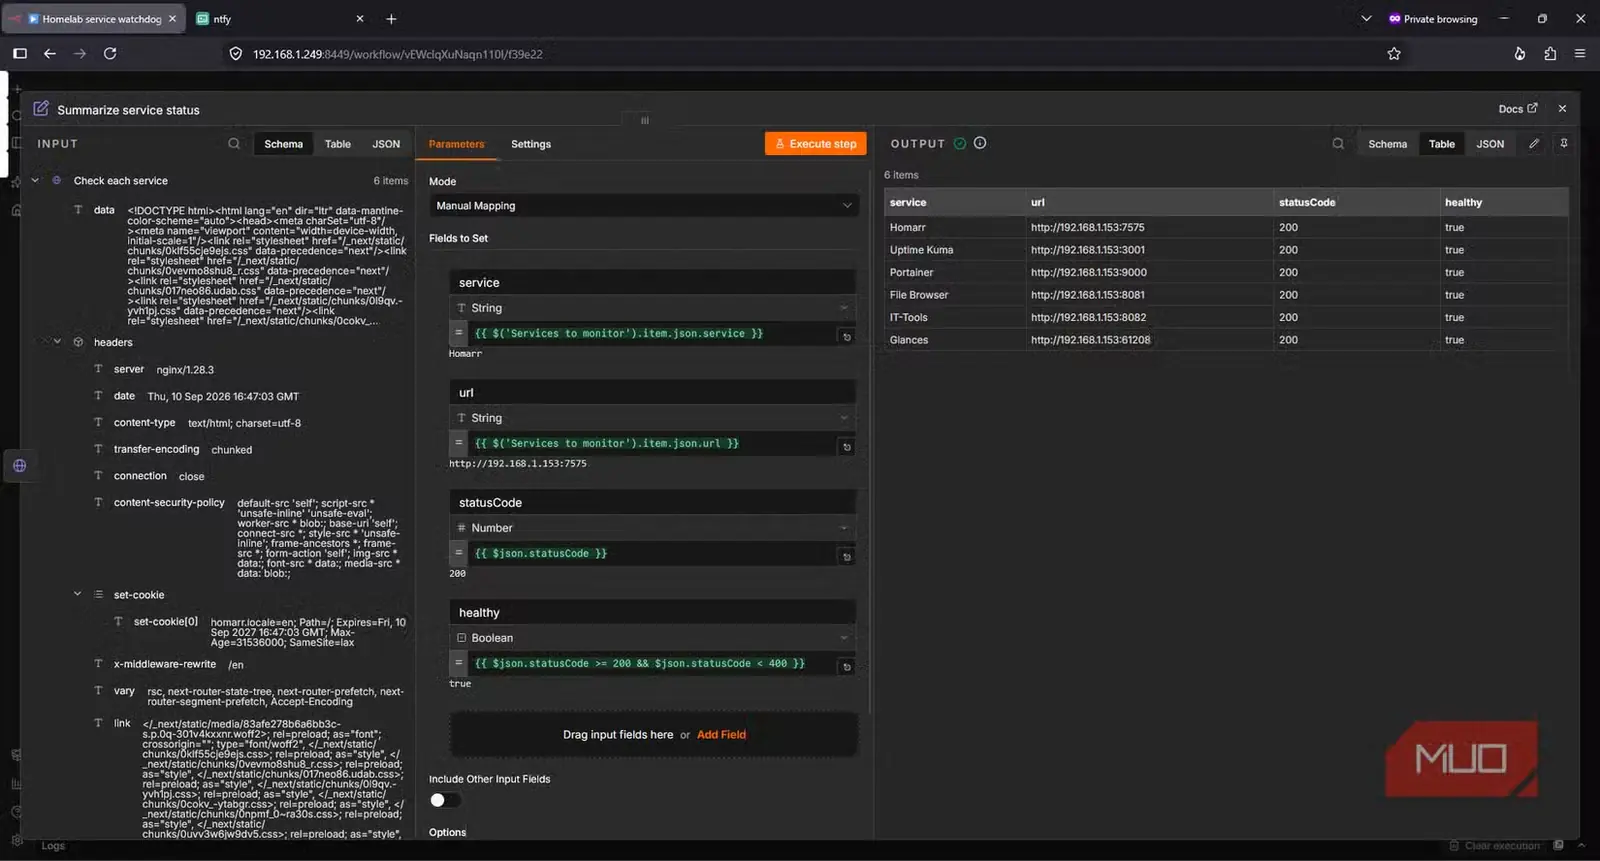
از آنجا که خروجی این درخواست تودهای عظیم و آشفته از اچتیامال بود، سپس با گرهٔ «ویرایش فیلدها» (Edit Fields) هر نتیجه را به نام سرویس، نشانی وب، وضعیت و یک مقدار بولی «سالم است» (isHealthy) خلاصه کردم. پاسخهای ۲۰۰ تا ۳۹۹ را «سالم» در نظر گرفتم تا تغییرمسیر آپتایم کوما نیز پذیرفته شود. اتصال ردشده بهجای متوقفکردن کل گردشکار، وضعیت 0 میگرفت.
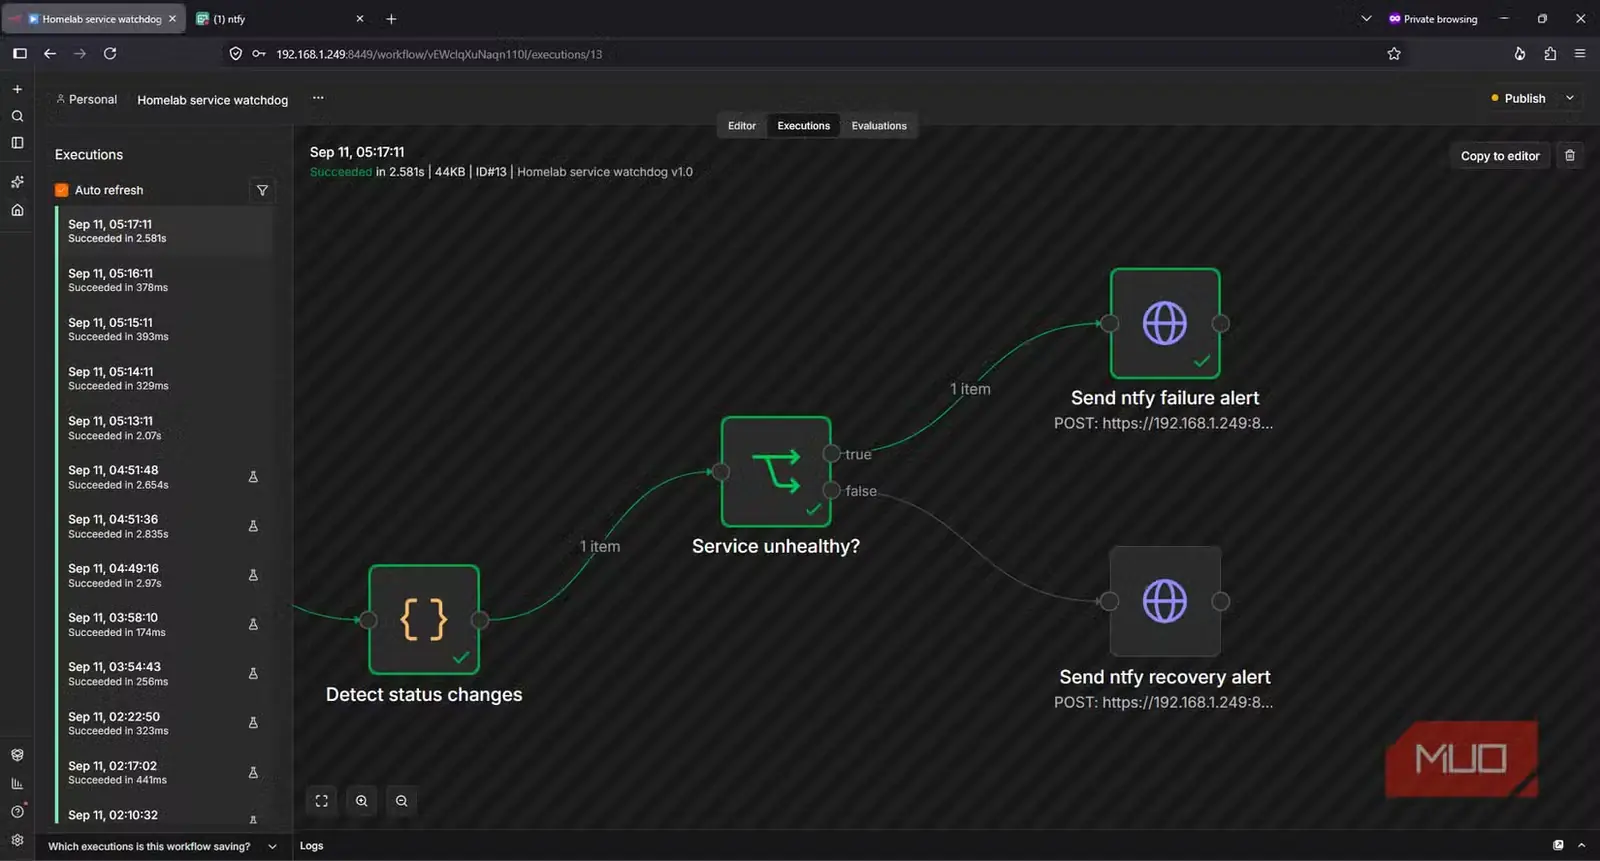
گره «کد» بعدی، وضعیت پیشین هر سرویس را به خاطر میسپارد. این گره در هر اجرای زمانبندیشده، وضعیت را بهروزرسانی میکند؛ اما تنها زمانی یک مورد خروجی میدهد که وضعیت از «در دسترس» (up) به down تغییر کرده باشد یا برعکس:
const state = $getWorkflowStaticData('global');
const changes = [];
for (const item of $input.all()) {
   const currentState = item.json.healthy ? 'up' : 'down';
   const previousState = state[item.json.service];

   state[item.json.service] = currentState;

   if (previousState !== undefined && previousState !== currentState) {
     changes.push({
         json: { ...item.json, previousState, currentState }
     });
   }
}

return changes;
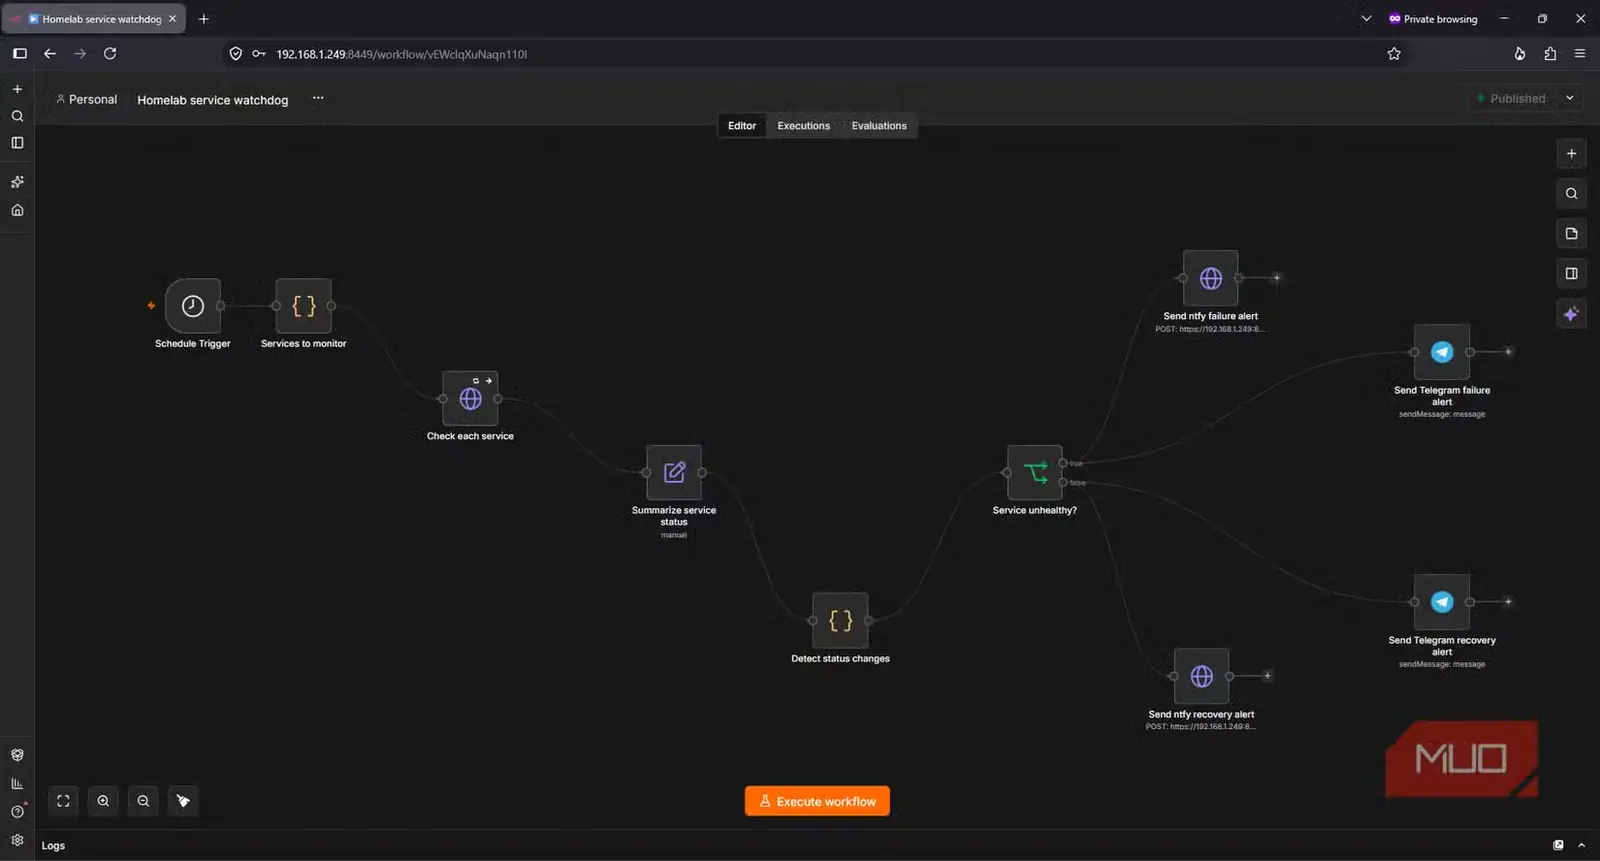
اینجا بود که به چند مشکل برخوردم. در چیدمان نخست، که برای فرستادن اعلان به یک ربات تلگرام طراحی کرده بودم، گره مربوط به ربات پس از ntfy قرار داشت. در نتیجه، بهجای رکورد سرویس، پاسخ API سرویس ntfy را دریافت میکرد.
اعلان حاصل نیز با اطمینان اعلام کرد: «undefined از کار افتاده است.» اتصال دوباره هر دو کانال بهصورت موازی، مشکل را برطرف کرد و درس سودمندی دربارهٔ سازوکار خطی خودکارسازی دیداری به من داد.
از کار انداختن سرویسهای خودم ثابت کرد هشدارها درست کار میکنند
سکوت پس از نخستین هشدار، بخشی از آزمایش بود
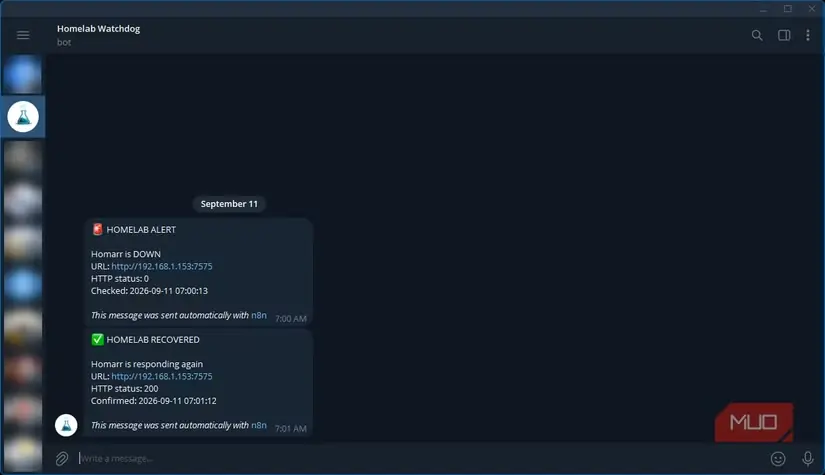
کانتینرهای هومآپس من سرسخت بودند و بیدردسر به کارشان ادامه میدادند. بنابراین، برای آزمودن خودکارسازی ناچار شدم عمداً چیزی را از کار بیندازم. هومار را متوقف کردم و منتظر ماندم تا n8n در اجرای زمانبندیشده بعدی، قطعی را شناسایی کند.
docker stop homarrمورد حاصل همچنان نام و نشانی اینترنتی سرویس را در خود داشت، اما مقدار وضعیتش 0 و مقدار healthy آن false بود. این یعنی خود اتصال شکست خورده بود، نه اینکه صرفاً یک صفحه HTTP نامطلوب بازگردانده شده باشد. پس از آنکه گردشکار خودکار این وضعیت را تشخیص داد، یک هشدار فوری از سرور شخصی ntfy و هشداری دیگر از ربات خصوصی تلگرام من رسید.
گذاشتم هومار برای یک چرخهٔ پنجدقیقهای دیگر متوقف بماند. چون گردشکار وضعیت ازکارافتادگی را به خاطر سپرده بود، هشدار دیگری نرسید. بدون این قابلیت، خرابی یک کانتینر میتوانست تا زمان رفع مشکل، هر دو سرویس ntfy و تلگرام را از هشدارهای تکراری و آزاردهنده پر کند.
سپس هومار را دوباره راهاندازی کردم و منتظر ماندم تا curl دریافت پاسخ HTTP ۲۰۰ را تأیید کند:
docker start homarrcurl -sS -L -o /dev/null -w 'HTTP %{http_code}\n' http://192.168.1.153:7575 اجرای زمانبندیشده بعدی، بازگشت وضعیت به up را تشخیص داد و تنها یک پیام بازیابی برای هر دو سرویس ntfy و تلگرام فرستاد. تکرار همین آزمایش با کانتینرهای File Browser و IT-Tools نیز همان روند قطعی و بازیابی و همان هشدارهای مورد انتظار را در پی داشت.
گزارش صبحگاهیام از یک داشبورد دیگر سودمندتر شد
گلنسز دادهها را فراهم کرد و n8n آنها را خواندنی ساخت
گردشکار تشخیص قطعی، مشکل اعلان خرابیهای فوری را حل کرده بود؛ اما همچنان میخواستم هر روز با نگاهی سریع از وضعیت سرور و کانتینرها باخبر شوم. بنابراین، گردشکار دومی ساختم که هر روز ساعت ۸ صبح، بر پایهٔ منطقهٔ زمانی از پیش تنظیمشده در n8n، اجرا شود.
دو گره «درخواست HTTPS» از مسیرهای /api/۴/mem و /api/۴/containers در Glances داده گرفتند. سپس یک گره «کد» پاسخها را در پیامی خلاصه کرد که شامل این موارد بود:
- تعداد مورد انتظار کانتینرها.
- میزان مصرف حافظه.
- حافظهٔ در دسترس.
- هر سرویسی که نیازمند رسیدگی تشخیص داده شده بود.
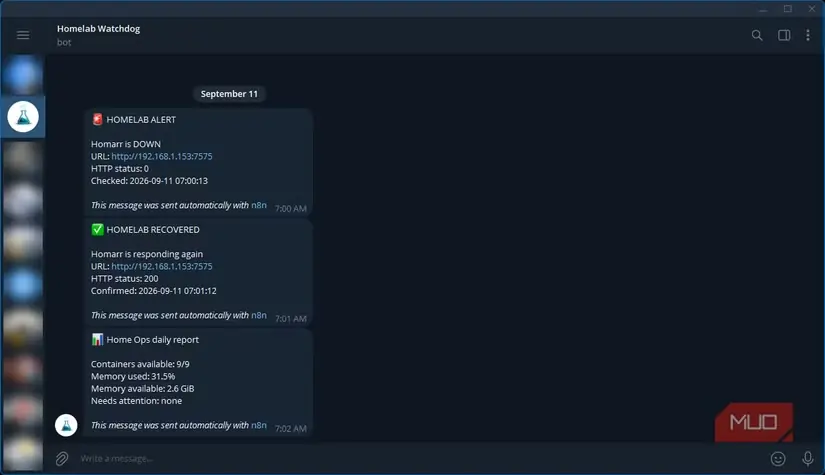
از آنجا که همهچیز از پیش در حال اجرا بود، نتیجه طبق انتظار اطمینانبخش و البته کسلکننده بود: هر ۹ کانتینر در دسترس بودند، ۳۲٪ حافظه مصرف شده بود، هنوز ۲٫۶ گیبیبایت حافظهٔ آزاد وجود داشت و هیچ موردی به رسیدگی نیاز نداشت. n8n همین خلاصهٔ خوانا را از هر دو مسیر ntfy و تلگرام فرستاد؛ مرور آن سر میز صبحانه بسیار آسانتر از باز کردن هومار بود.
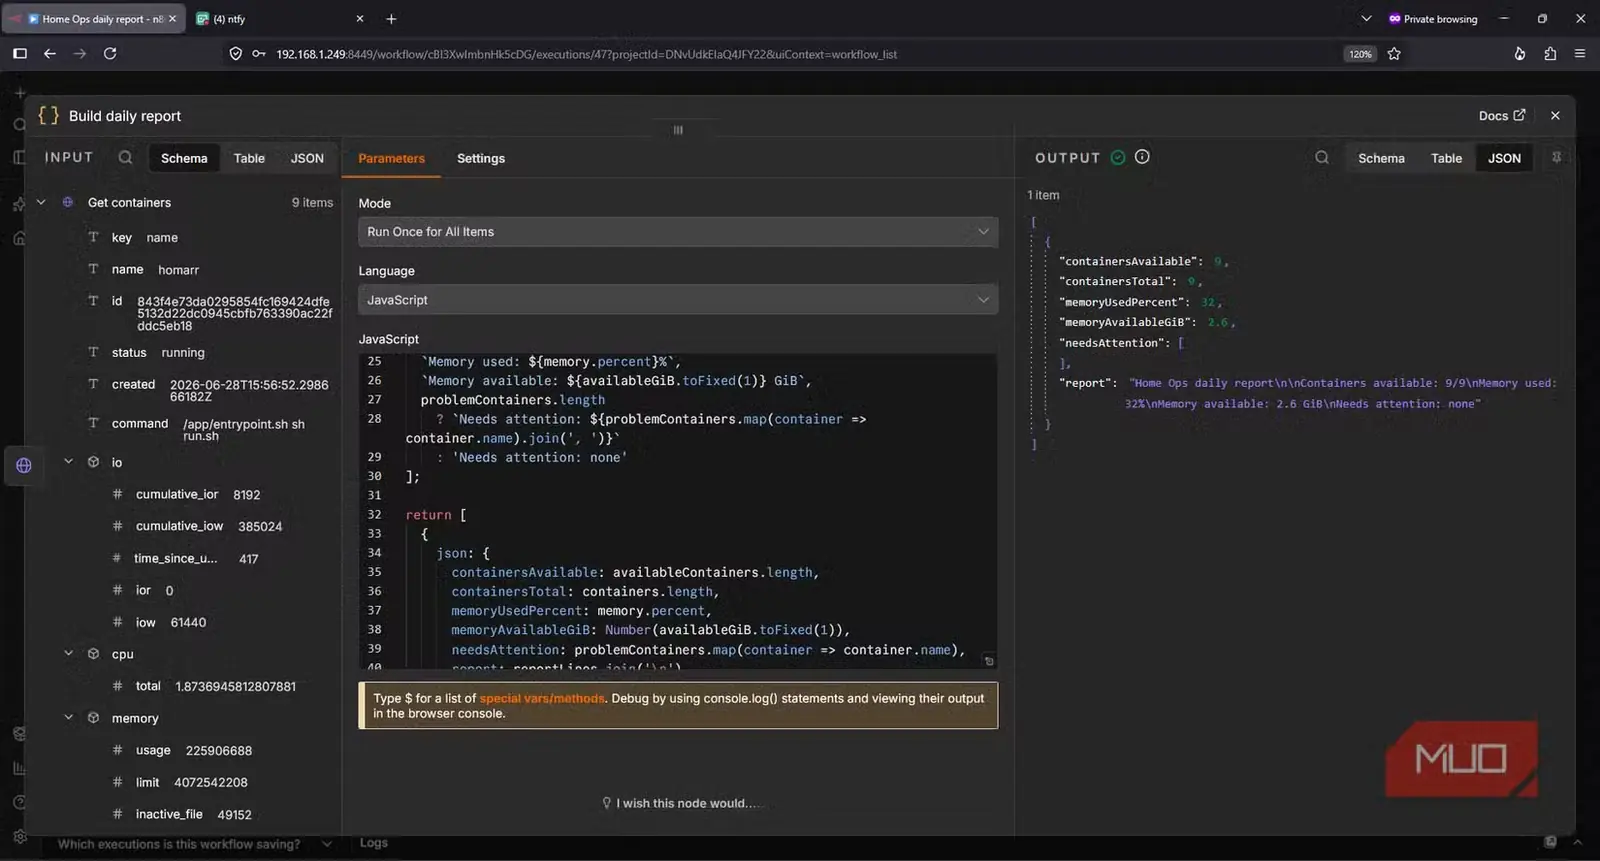
شمارش کانتینرها به اصلاح کوچکی نیاز داشت. Glances کانتینر متوقفشده را بهجای آنکه با وضعیت «متوقف» بازگرداند، بهکلی از پاسخ حذف میکرد. بنابراین، شمارش صرفِ موارد پاسخ میتوانست یک خرابی واقعی را به نتیجهٔ ظاهراً عادی «هشت از هشت» تبدیل کند، در حالی که نتیجهٔ درست «هشت از نه» بود.
پس فهرستی ثابت از ۹ کانتینر مورد انتظارم ساختم و پاسخ API را با آن سنجیدم:
const reportLines = [
     'Home Ops daily report',
     '',
     `Containers available: ${availableNames.length}/${expectedContainerNames.length}`,
     `Memory used: ${memory.percent}%`,
     `Memory available: ${availableGiB.toFixed(1)} GiB`,
     problemNames.length
        ? `Needs attention: ${problemNames.join(', ')}`
        : 'Needs attention: none'
];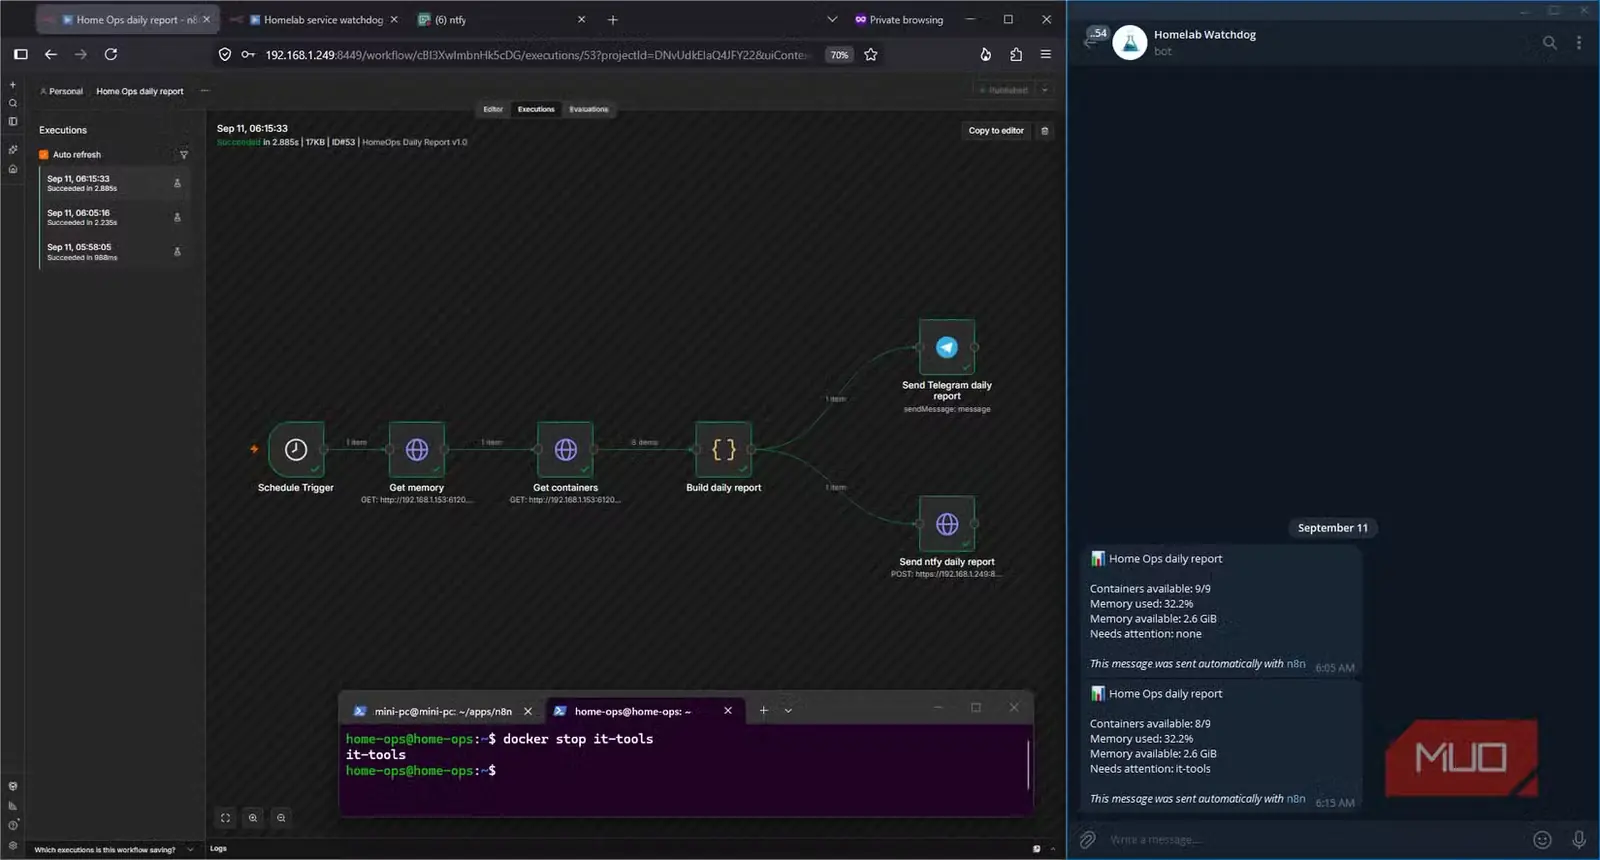
متوقف کردن IT-Tools نشان داد که این تغییر درست کار میکند. گزارش بعدی، نتیجهٔ «هشت از نه» را نشان داد و نام IT-Tools را زیر بخش «نیازمند رسیدگی» آورد. پس از راهاندازی دوبارهٔ آن، گزارش پاکِ «نه از نه» بازگشت.
آپتایم کوما سادهتر است، اما n8n راه پیشرفت آینده را باز میگذارد
هشدارها اکنون کار میکنند و گردشکار شاید روزی خودش مشکل را برطرف کند
Uptime Kuma همیشه نخستین پیشنهاد من برای نرمافزار پایش خواهد بود. کافی است یک نشانی اینترنتی و بازهٔ زمانی به آن بدهید و بگذارید کارش را انجام دهد. راهاندازی n8n پیچیدهتر بود. برای دستیابی به همان قابلیتها، به این موارد نیاز داشتم:
- داکر.
- اطلاعات ورود.
- پاکسازی پاسخها.
- ردیابی وضعیت.
- اتصالهای دقیق.
اشتباهکردن هم آسان است؛ نمونهاش مشکل اتصالی بود که با قراردادن گرههای اعلان تلگرام پس از ntfy به وجود آوردم. جداکردن آن از سرور هومآپس این نقطهکور را از میان برداشت، اما هنوز نقاط ضعف دیگری وجود دارد. اگر مینیپیسی یا مسیریاب از کار بیفتد، یا خودم در پیکربندی شبکه اشتباهی کنم، هر دو گردشکار خاموش خواهند شد.
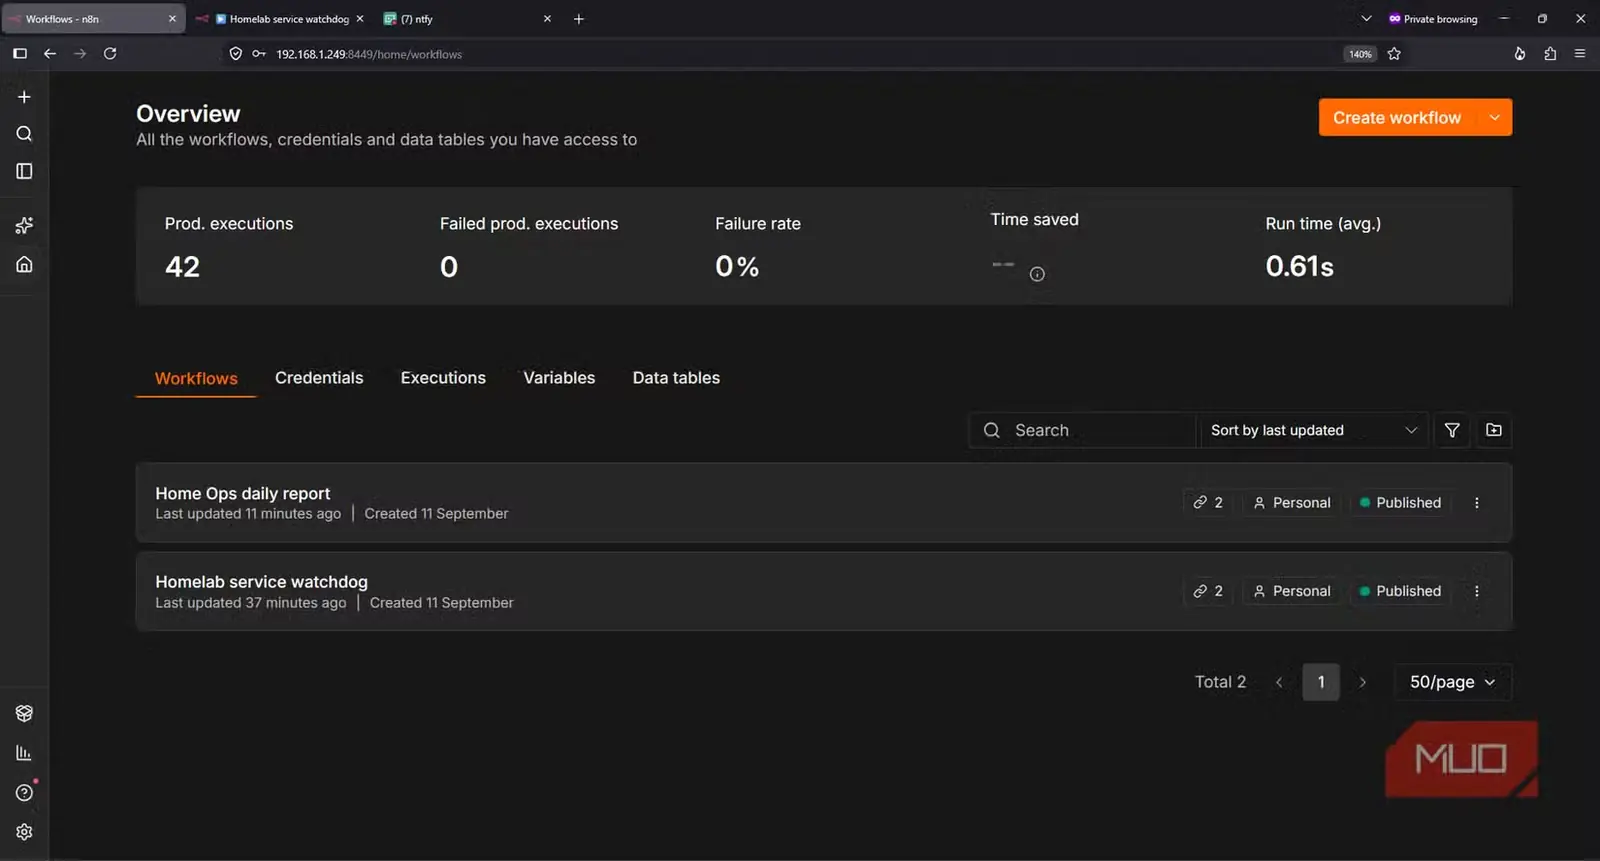
تفاوت بزرگ اینجاست که Uptime Kuma فقط به من میگوید مقصدی پاسخ میدهد یا نه، اما n8n راهی پیش پایم میگذارد تا گام بعدی را بردارم. سامانهٔ من اکنون درخواستها را دوباره میآزماید، اعلانهای تکراری را کنار میگذارد، بازیابی سرویسها را تشخیص میدهد، از دو کانال اعلان میفرستد و گزارشی صبحگاهی میسازد؛ اما این تازه آغاز کار است.
گره SSH در n8n میتواند فرمانهایی را روی دستگاهی دوردست اجرا کند؛ بنابراین نسخهای پیشرفتهتر بهسادگی میتواند یک بار و بهصورت کنترلشده فرمان docker restart را اجرا کند، نشانیها را دوباره بررسی کند و موفقیت یا شکست این اقدام اصلاحی را گزارش دهد.
همین میدان گسترده برای توسعه و آزمودن ایدههای بیشتر است که باعث میشود n8n را بهعنوان لایهٔ خودکارسازی، بالاتر از Uptime Kuma نگه دارم. امروز آزمایشگاه خانگیام خرابیها را همان لحظه گزارش میکند؛ اما فردا شاید پیش از آنکه حتی اعلانی دریافت کنم، نخستین تلاش برای تعمیر را نیز انجام دهد.
منبع: این مطلب ترجمه و بومیسازی مقالهای از MakeUseOf به قلم Gregory Gibson است. مشاهده مقاله اصلی